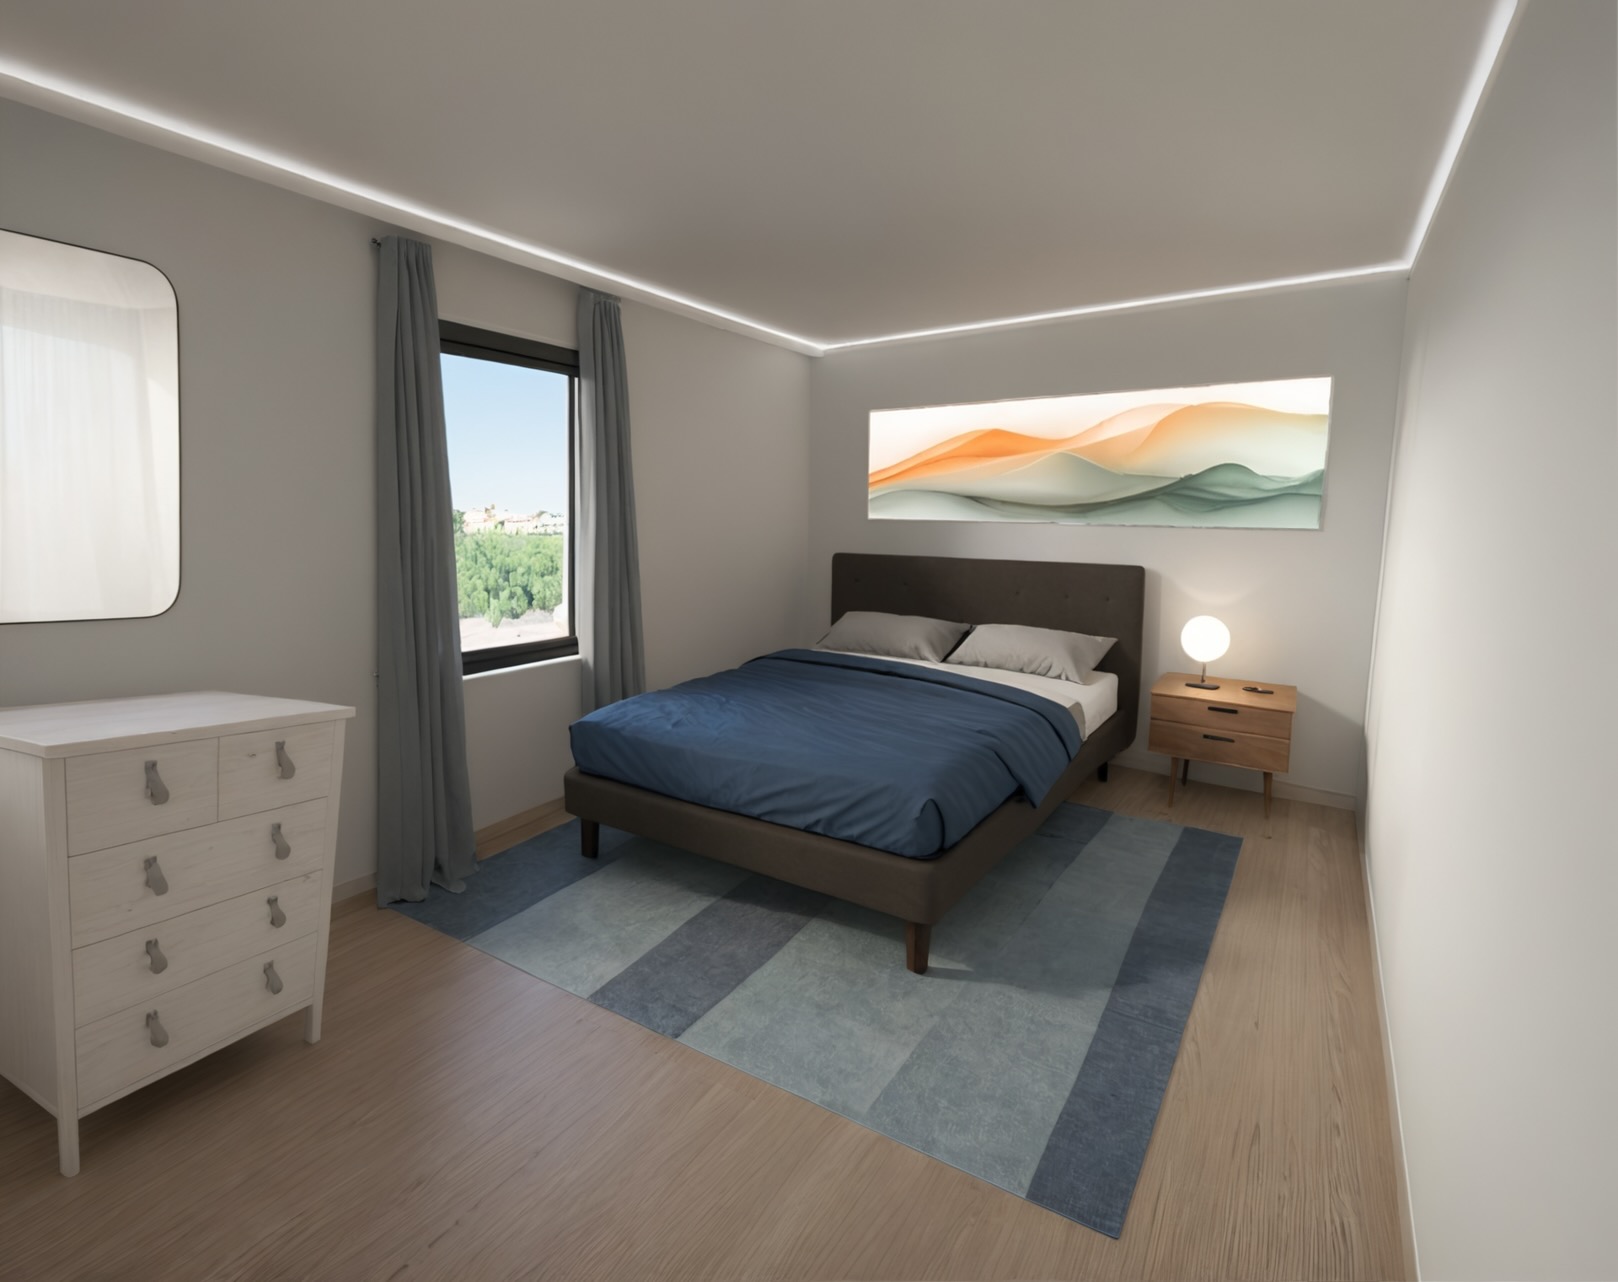
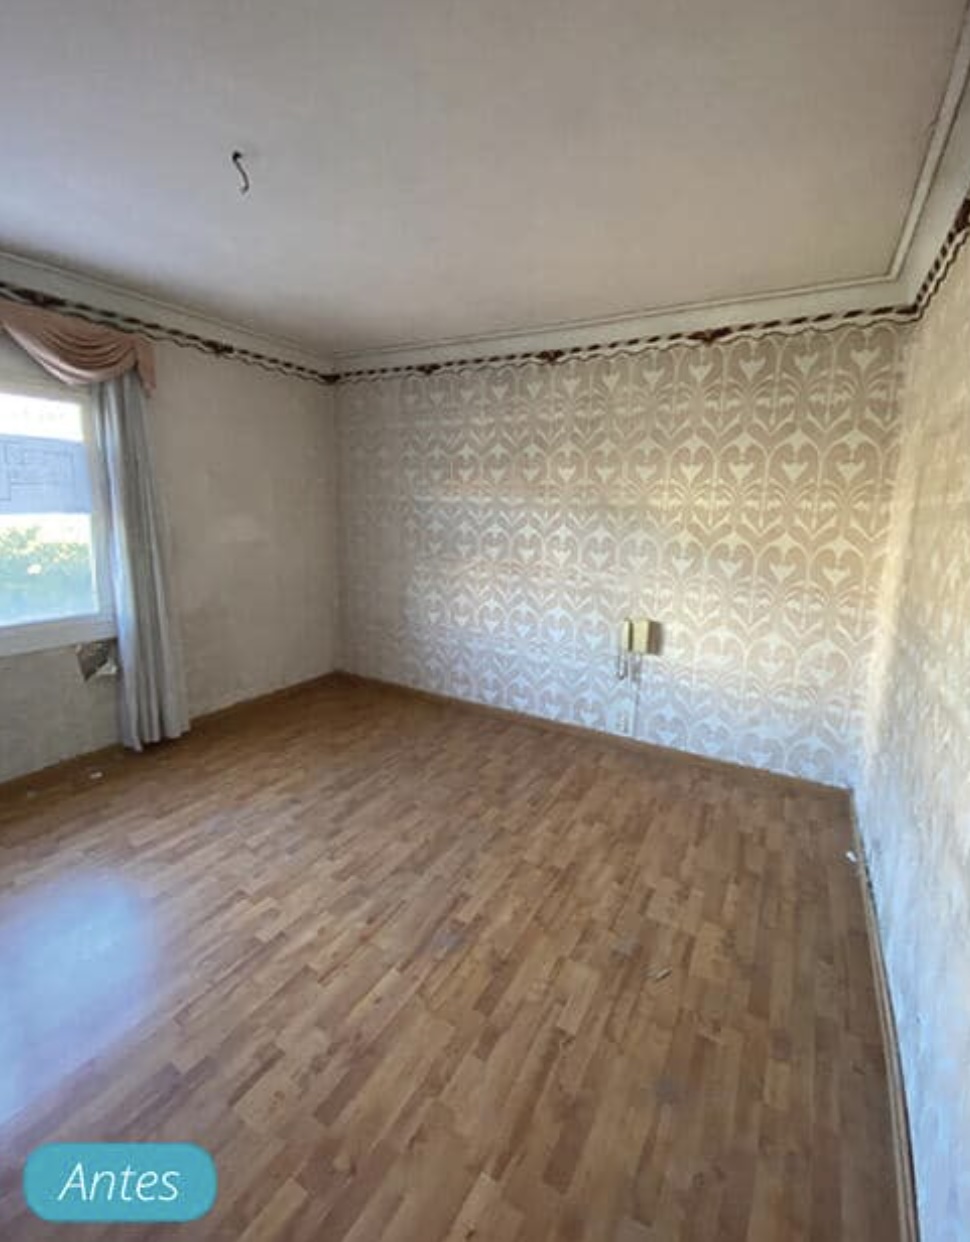
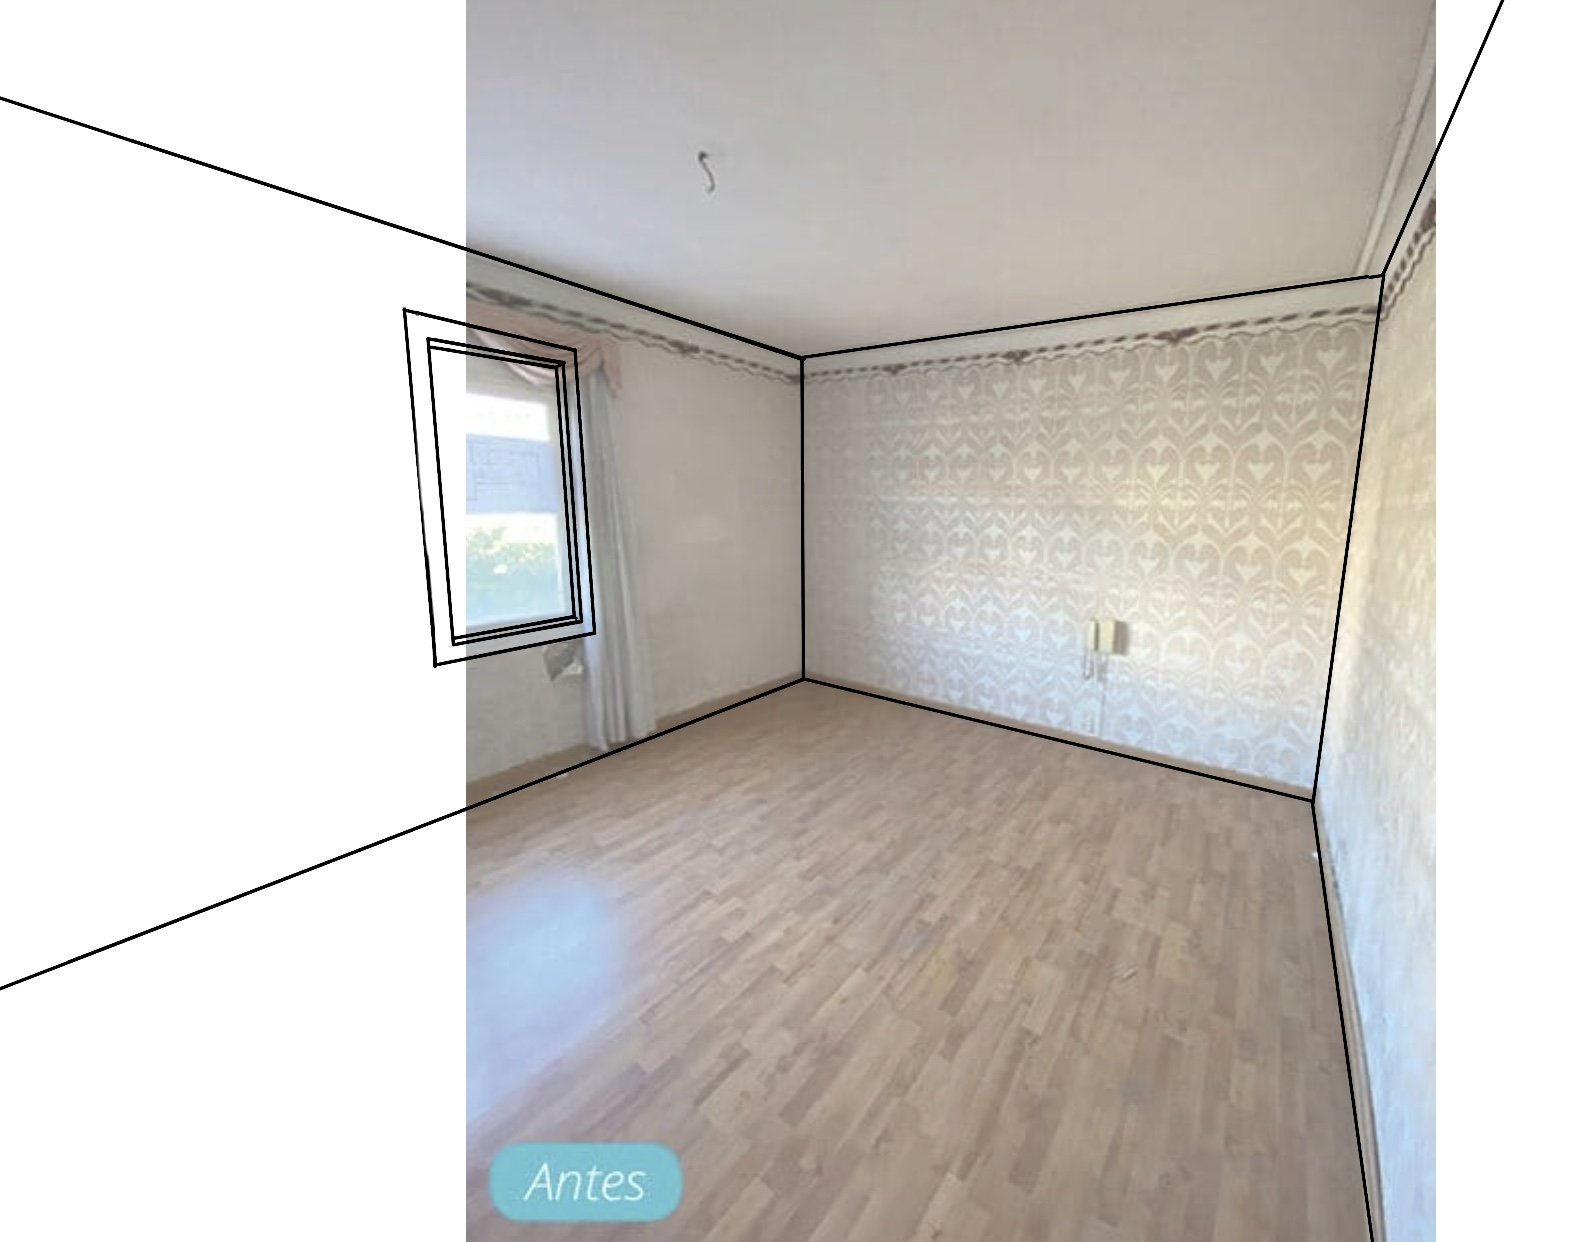
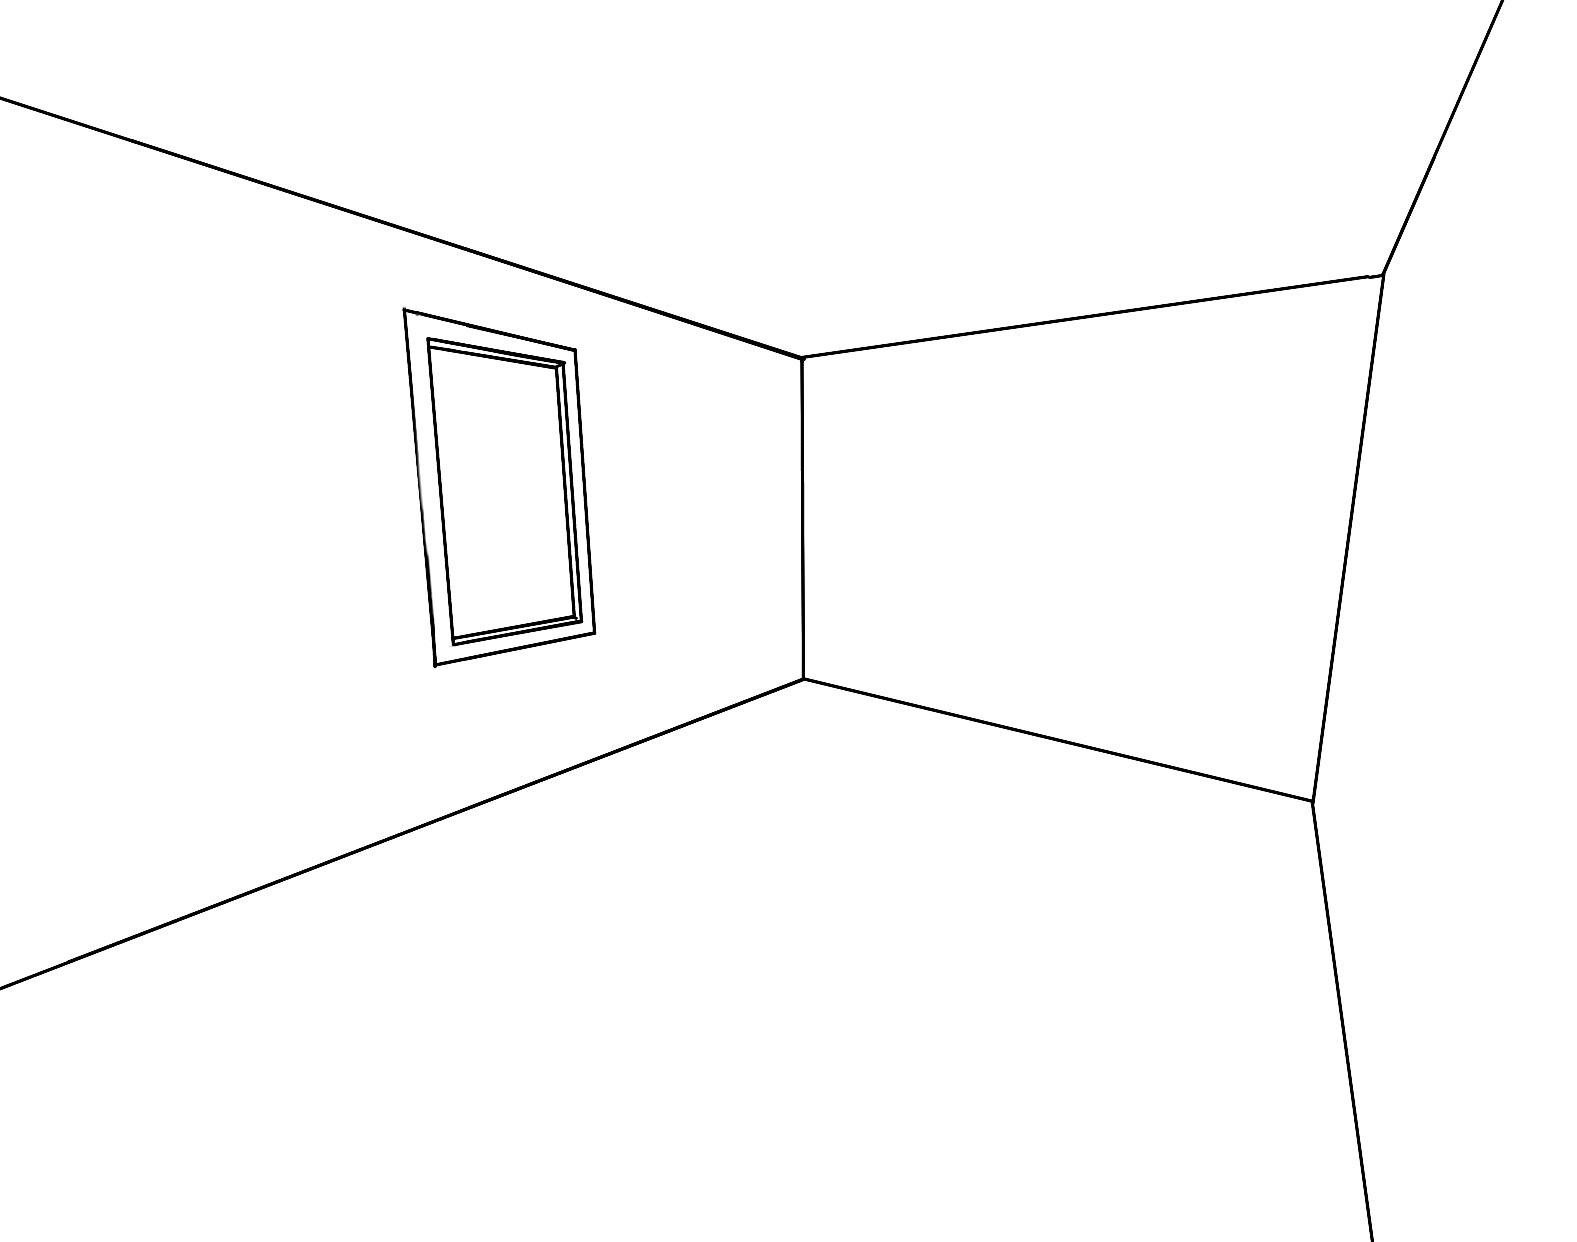
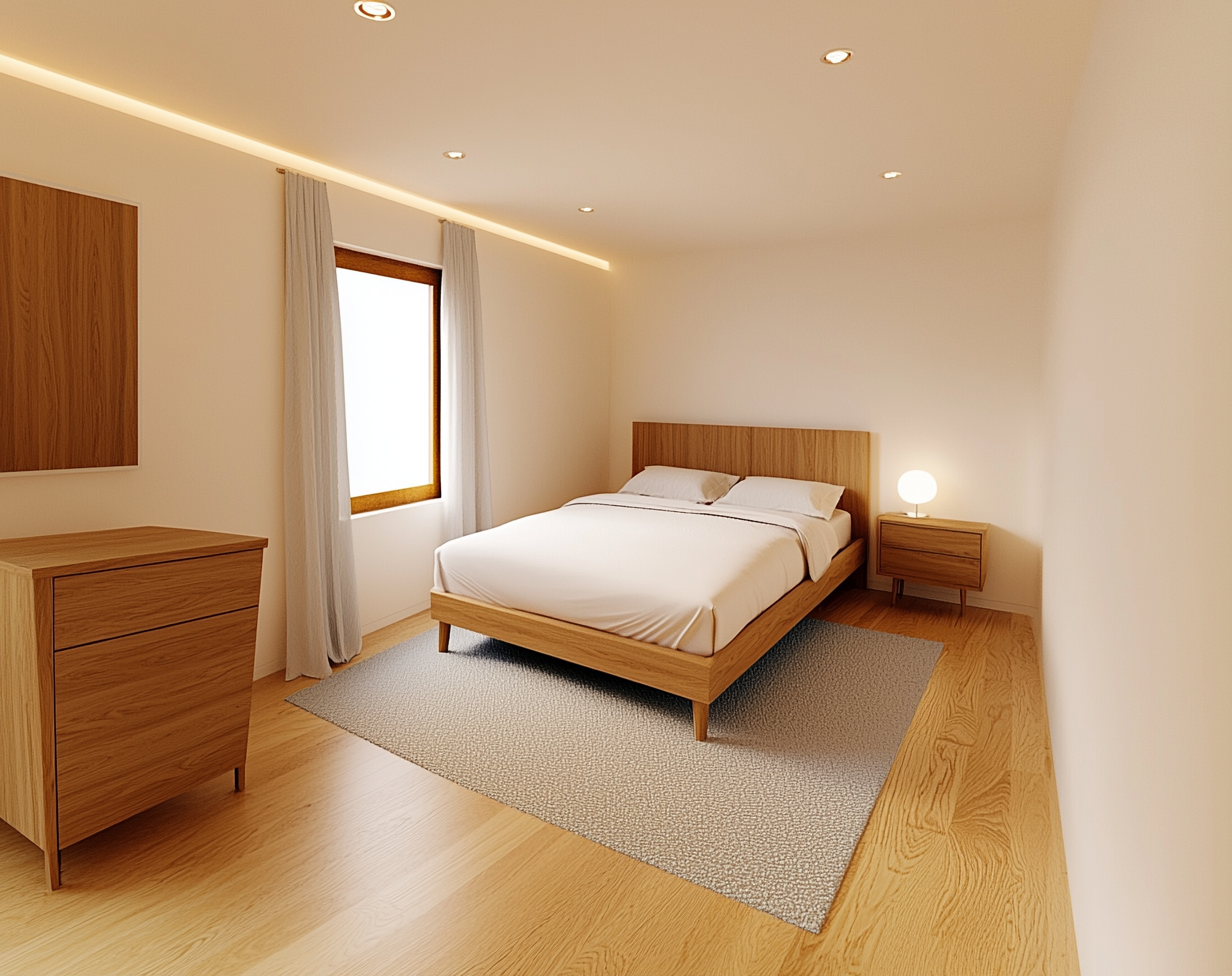
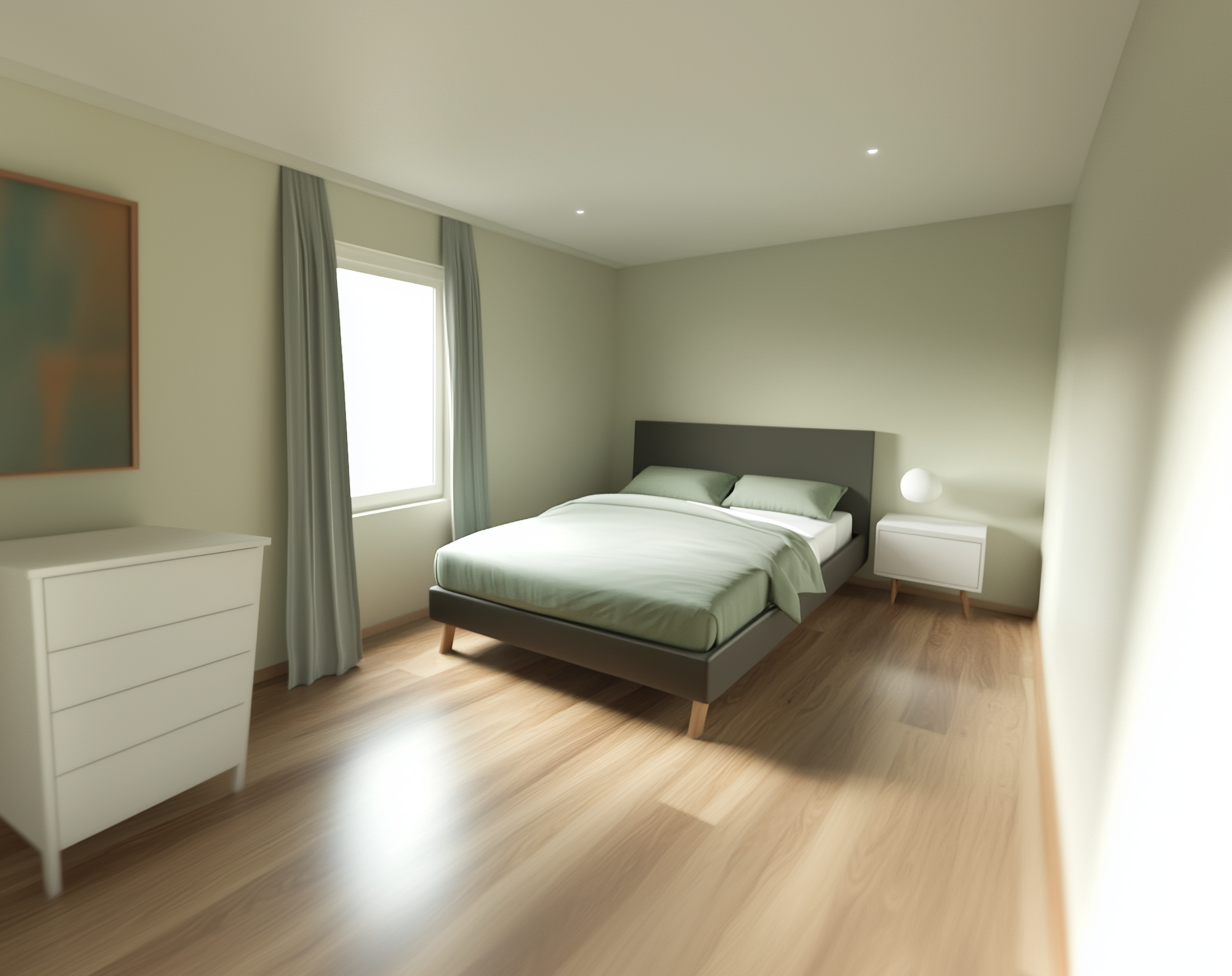
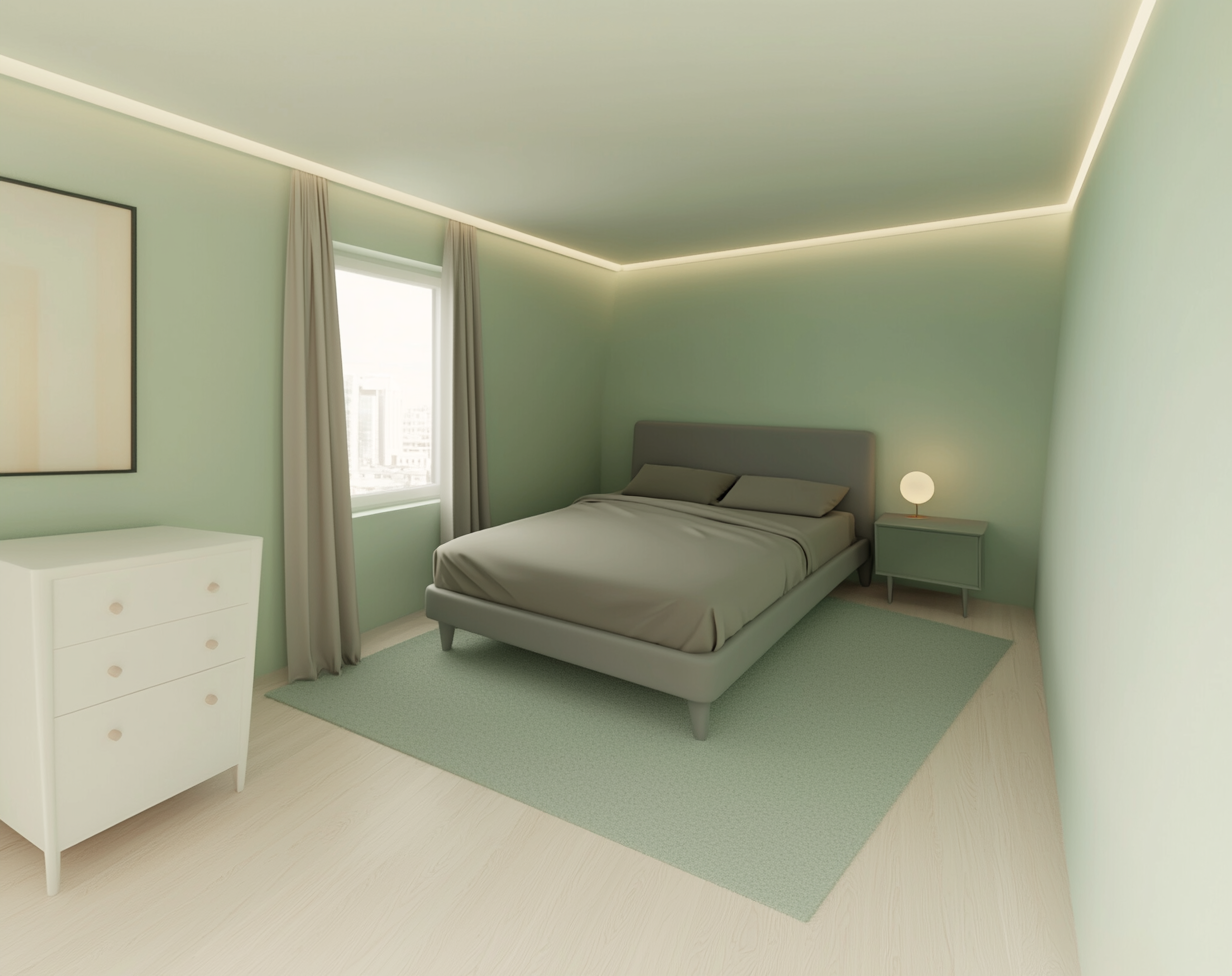
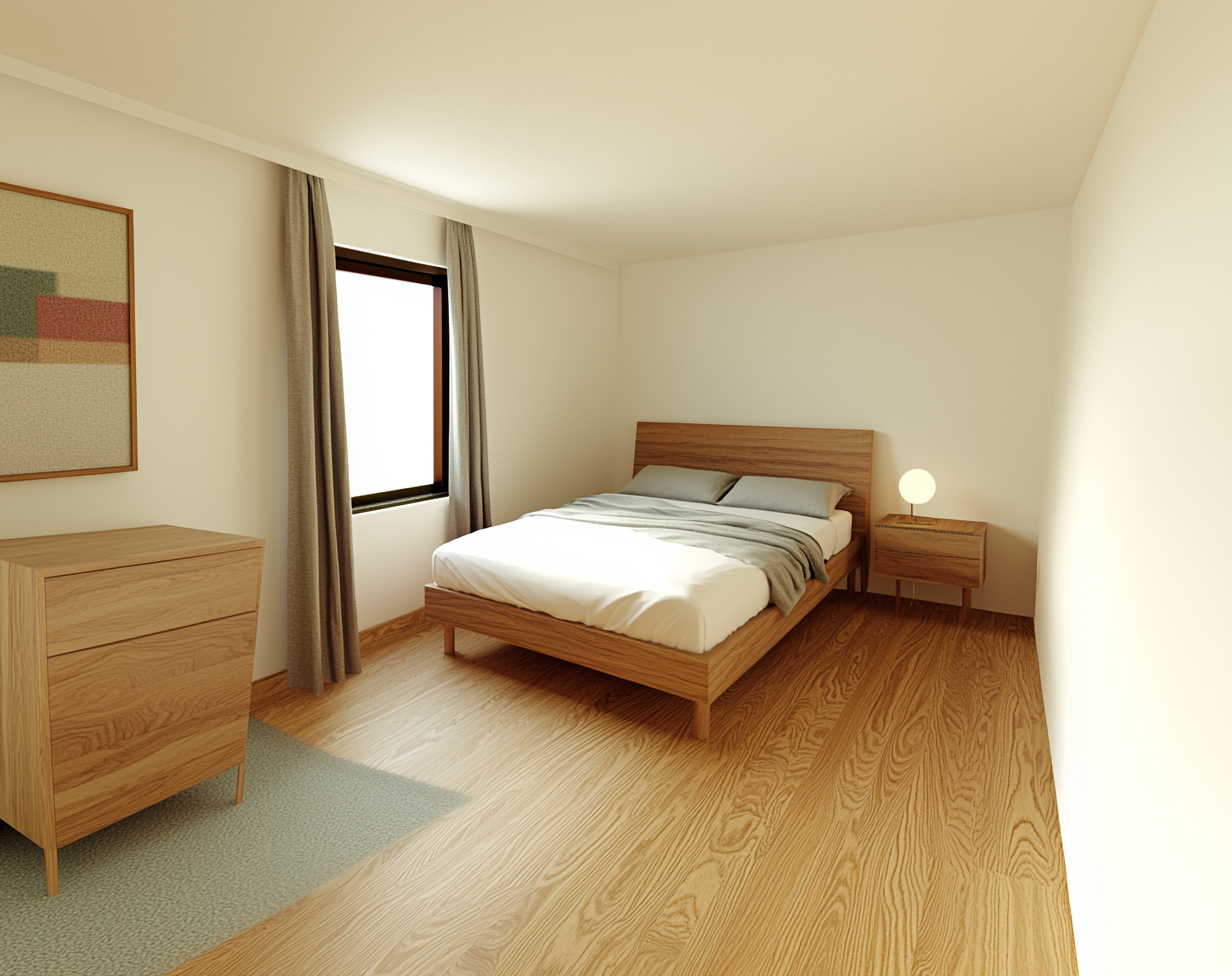
INTELIGENCIA ARTIFICIAL

APLICADA AL INTERIORISMO Y ARQUITECTURA

CONTROL

Ya conocemos la importancia del prompt como herramienta fundamental para generar contenido con Inteligencia Artificial Generativa.
El siguiente paso es aprender a controlar los resultados en la generación de imágenes.

Como ocurre al comunicarnos con una persona, una única descripción deja siempre un amplio margen a la interpretación. Y aunque esto puede enriquecer el proceso creativo, también puede alejarnos de lo que realmente necesitamos comunicar.

En nuestra práctica profesional, una de las tareas clave es transmitir ideas con precisión a clientes, gremios u otros agentes implicados. Por eso, se vuelve esencial contar con recursos que nos permitan definir y acotar los resultados de la IA generativa, alineándolos con nuestros objetivos.

En esta lección —una de las más relevantes del taller— vamos a avanzar desde la unidad más básica de control hasta lo que considero los elementos clave para alcanzar un mayor dominio sobre los resultados.
Este recorrido nos permitirá entender, paso a paso, cómo incorporar técnicas que refuercen el control sobre la imagen generada, y transformar así un prompt convencional en una herramienta mucho más precisa y dirigida. Vamos a ello.

En esta pestaña se contiene el mapa mental en el que podemos ver todo el proceso de control que desglosamos a continuación.

Control de estilo

Empecemos a explorar cómo influir en el estilo visual de nuestras imágenes utilizando recursos más avanzados que el simple texto del prompt.

Midjourney

Midjourney es u modelo de generación de imágenes que ha venido manteniendo el liderazgo en calidad y tras la apertura de su interface web, ha ido incorporando cada vez más opciones.

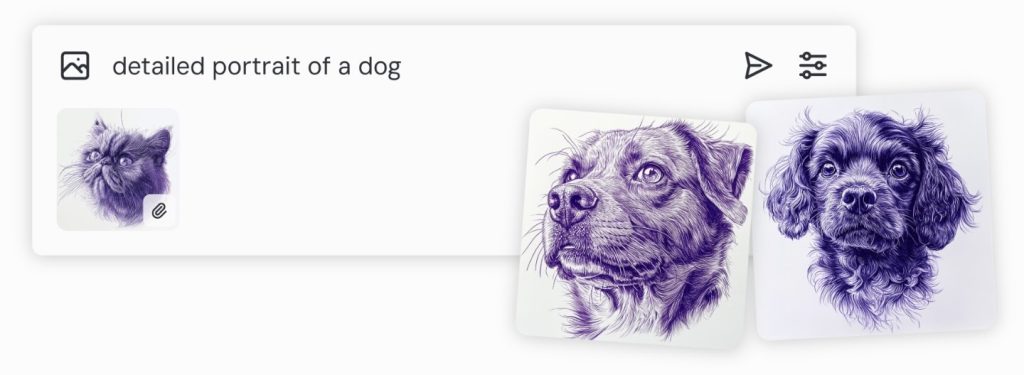
Midjourney cuenta con una herramienta muy potente para controlar el estilo de tus imágenes: el parámetro --sref. Este comando permite «capturar» la atmósfera visual de una imagen —colores, texturas, tipo de iluminación, medio artístico, etc.— y aplicarla a nuevas creaciones. Eso sí, no copia objetos concretos ni personas: solo el estilo general.

Detrás de esta función está el llamado espacio latente de Midjourney: un entorno abstracto donde se codifican los estilos visuales en coordenadas. Cuando usas --sref, estás apuntando directamente a una posición dentro de ese espacio, haciendo que tu imagen adopte esa estética sin necesidad de describirla.

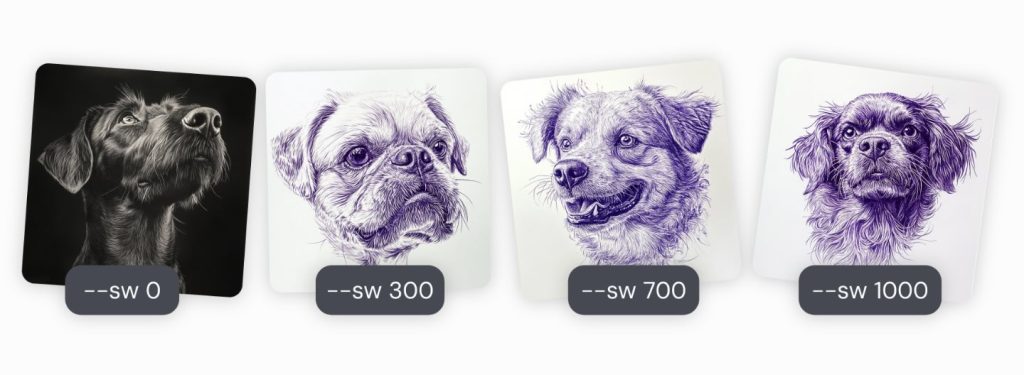
Puedes usar --sref añadiendo la URL de una imagen alojada en Discord o cargándola desde la interfaz web de Midjourney. Si quieres que el estilo tenga más o menos presencia en el resultado, puedes ajustar la intensidad con el parámetro --sw (style weight).

También puedes jugar con --sref random, que aplica un estilo aleatorio de la biblioteca interna de Midjourney. El sistema genera un código numérico de estilo (sref code) que puedes reutilizar para mantener ese mismo look en futuros prompts.

Y no acaba ahí: puedes combinar varias imágenes como referencia y asignar un peso distinto a cada una para crear mezclas estilísticas más complejas.

Eso sí, tiene sus limitaciones:

  • No puedes generar tu propio código --sref a partir de una imagen subida por ti.
  • A veces los resultados no son del todo coherentes, especialmente si el estilo no está bien definido o si combinas demasiadas referencias.

Importante: --sref no es lo mismo que --cref. Este último sirve para mantener la consistencia de personajes, no de estilos visuales.

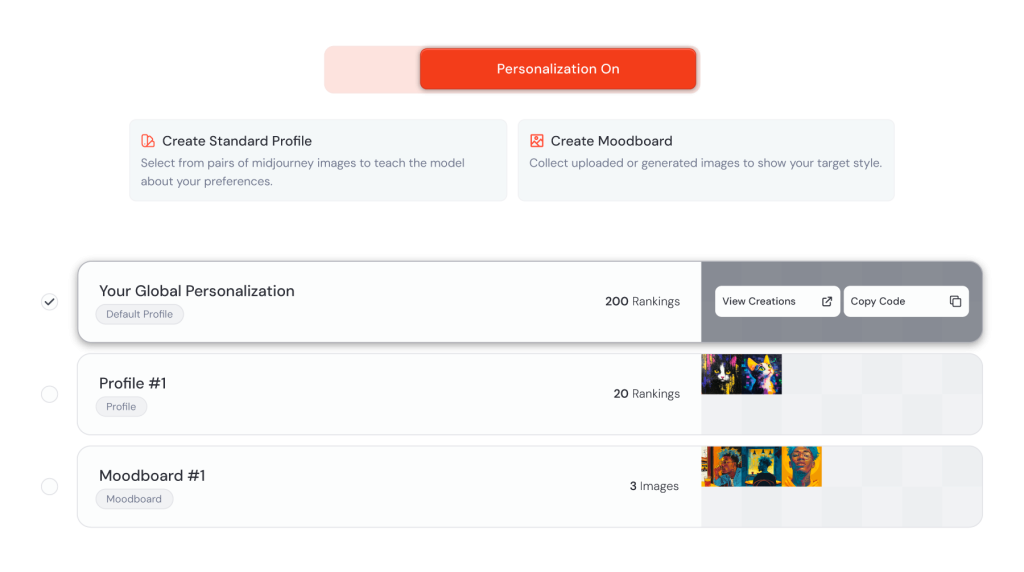
Midjourney también ofrece otras formas de controlar el estilo de tus imágenes, además del parámetro --sref. Dos de las más interesantes son los Moodboards y los Perfiles de Usuario.

En el caso de los Moodboards, puedes crear tantos como quieras. Simplemente añades un conjunto de imágenes que representen el estilo que te interesa, y Midjourney extrae de ellas un patrón visual propio. Es una forma de generar un estilo personalizado basado en tus referencias, como si fuera un entrenamiento a medida.

Por otro lado, los Perfiles de Usuario funcionan de forma inversa. Es Midjourney quien te muestra imágenes, y tú indicas cuáles te gustan dando «me gusta». A partir de cientos o miles de selecciones, el sistema construye un perfil automático de tus preferencias visuales y lo aplica a tus futuras generaciones.

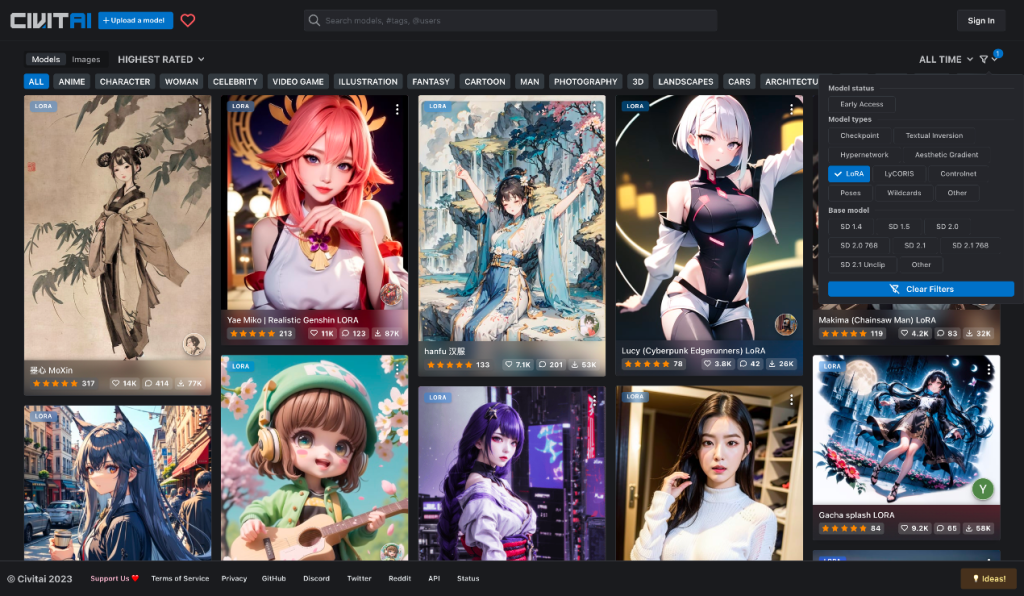
Los LoRAs (Low-Rank Adaptation) son una forma inteligente de personalizar grandes modelos de inteligencia artificial sin tener que reentrenarlos por completo. Lo que hacen es añadir una pequeña capa nueva (de bajo rango) sobre un modelo ya entrenado, y solo esa parte es la que se ajusta. El resultado: puedes adaptar el modelo a nuevos estilos, personajes o temáticas con muy poco esfuerzo computacional.

¿Para qué sirven los LoRAs?

Un LoRA puede estar entrenado, por ejemplo, en el estilo de Van Gogh, o en un personaje concreto. Al aplicarla, puedes generar imágenes con ese estilo o ese personaje en distintas poses o escenarios. Es una forma de inyectar características concretas sin tener que volver a describirlas desde cero cada vez.

Muchas veces, estos LoRAs funcionan con lo que se llaman «palabras clave activadoras» (trigger words) que se incluyen en el prompt. Esas palabras le dicen al modelo: “oye, usa este LoRA ahora”. Esto te da más control sobre cuándo y cómo se aplica esa personalización.

LoRAs + ControlNet: precisión total

Una de las combinaciones más potentes es usar LoRAs junto a ControlNet. Mientras ControlNet te permite controlar la estructura de la imagen (pose, profundidad, silueta…), LoRA se encarga de afinar el estilo o el contenido visual.

Por ejemplo: puedes definir la pose de un personaje con ControlNet y luego aplicar un LoRA para que tenga la estética de un cómic, de un retrato clásico o de tu personaje favorito.

Si además trabajas en entornos modulares como ComfyUI, la integración es aún más potente. Puedes mezclar distintos LoRAs, controlar pesos, combinarlas con otros sistemas… y conseguir resultados hiperpersonalizados.

CivitAI es una web dónde los usuarios alojan LoRAs descargables para utilizar con distintos modelos

Distintas --sref o referencias de estilo aplicadas a una imagen en Midjourney

Control de forma

A través del prompt, no solo definimos el aspecto de la imagen, sino también una gran cantidad de detalles que transforman el resultado final. Podemos especificar el punto de vista de la cámara, jugar con desenfoques y profundidad de campo, ajustar la iluminación y la atmósfera, incorporar texturas y detalles específicos, e incluso situar la escena en ubicaciones precisas. Cada uno de estos elementos nos permite refinar la imagen y acercarnos con mayor precisión a la visión que tenemos en mente.

De servilleta de bar a...

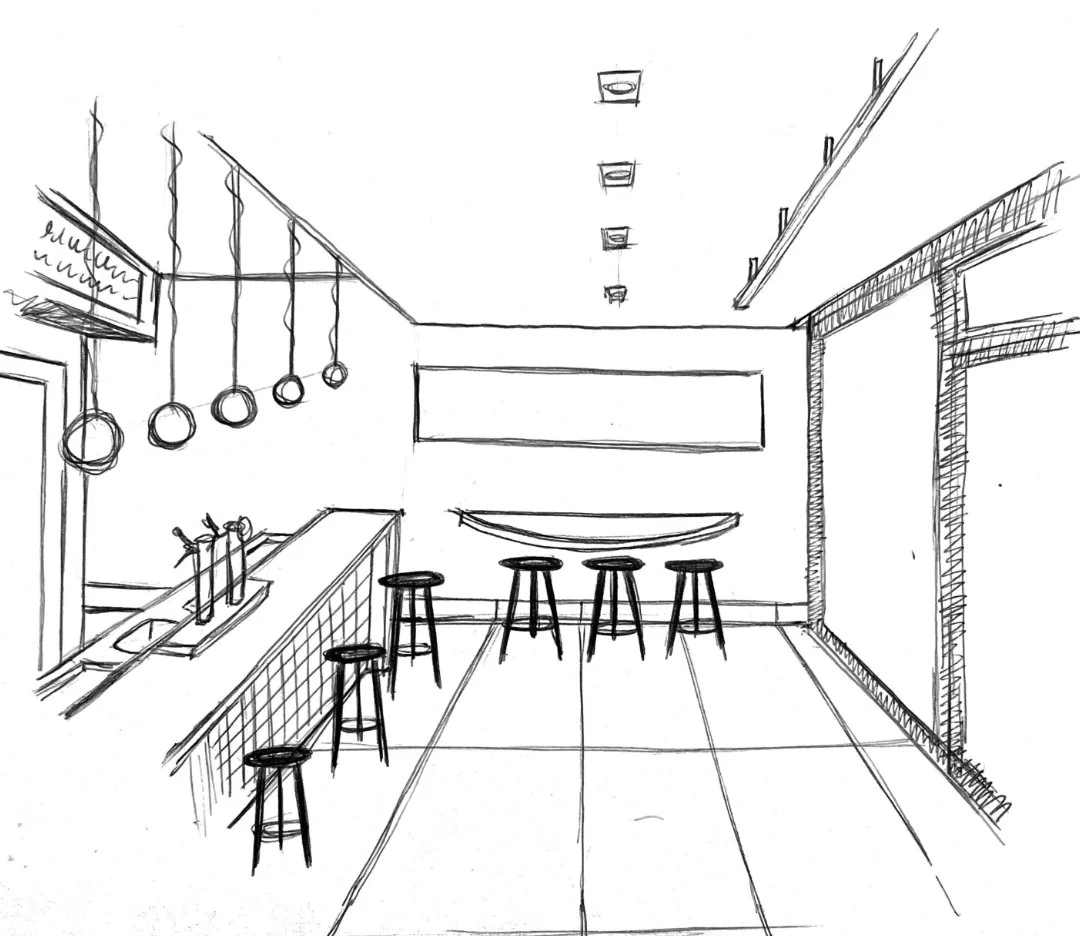
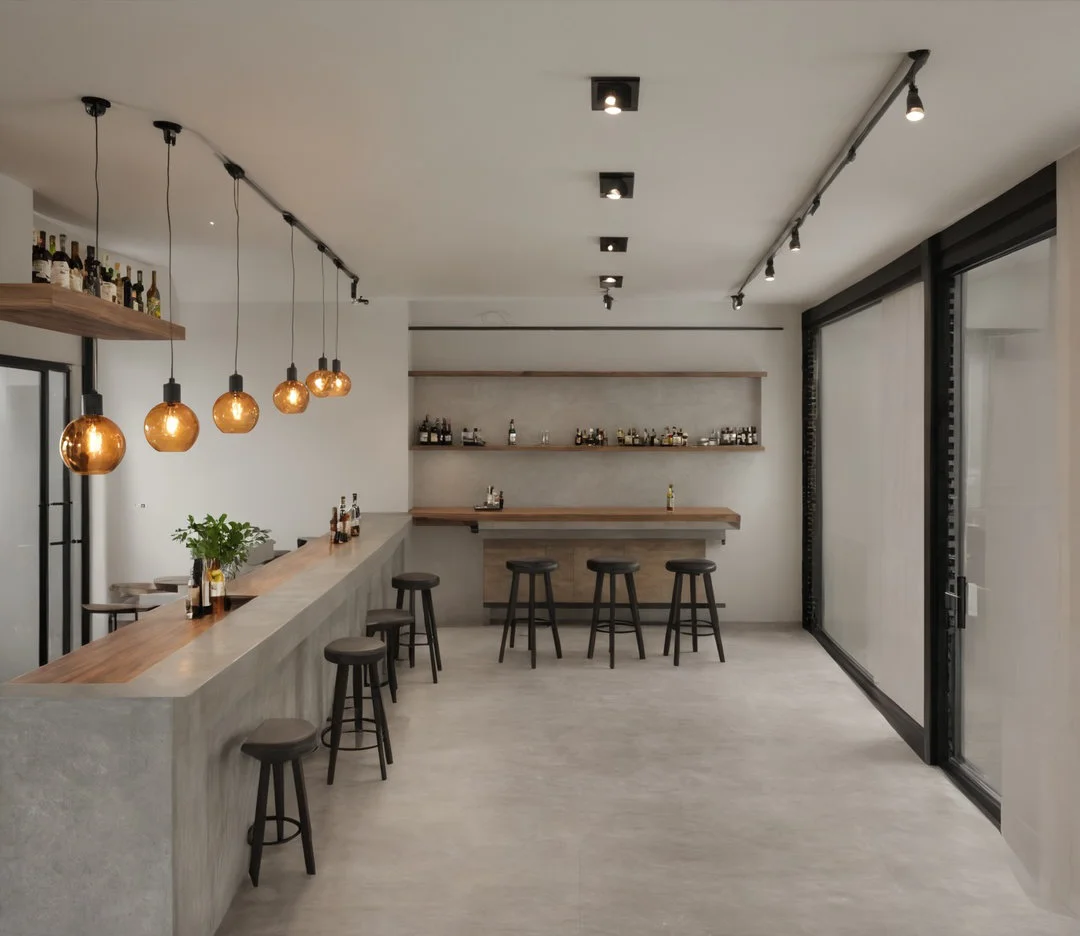
Este puede ser uno de los casos más extremos de aprovechamiento creativo: partir de un boceto rápido, garabateado en una servilleta de bar, y convertirlo en una imagen con la que ya se puede empezar a hablar con un cliente.

El esquema original puede ser tosco, improvisado y poco claro, pero con una simple foto tomada con el móvil y apenas 15 o 20 minutos de pruebas, el resultado pasa de lo informal a lo presentable. No se trata de una imagen definitiva, pero sí de un punto de partida válido.

Una inversión mínima de tiempo —unos 10 minutos de dibujo y unos pocos ajustes— puede dar lugar a una propuesta visual que abre la conversación.

Cómo percibe la IA las formas: imagen de control.

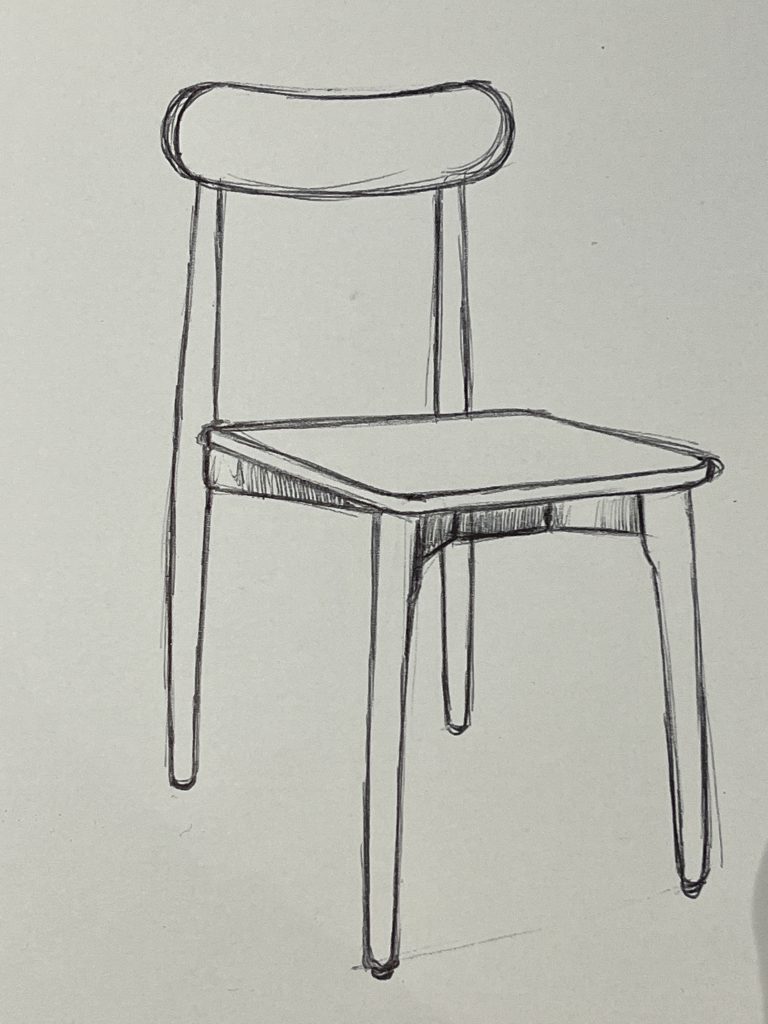
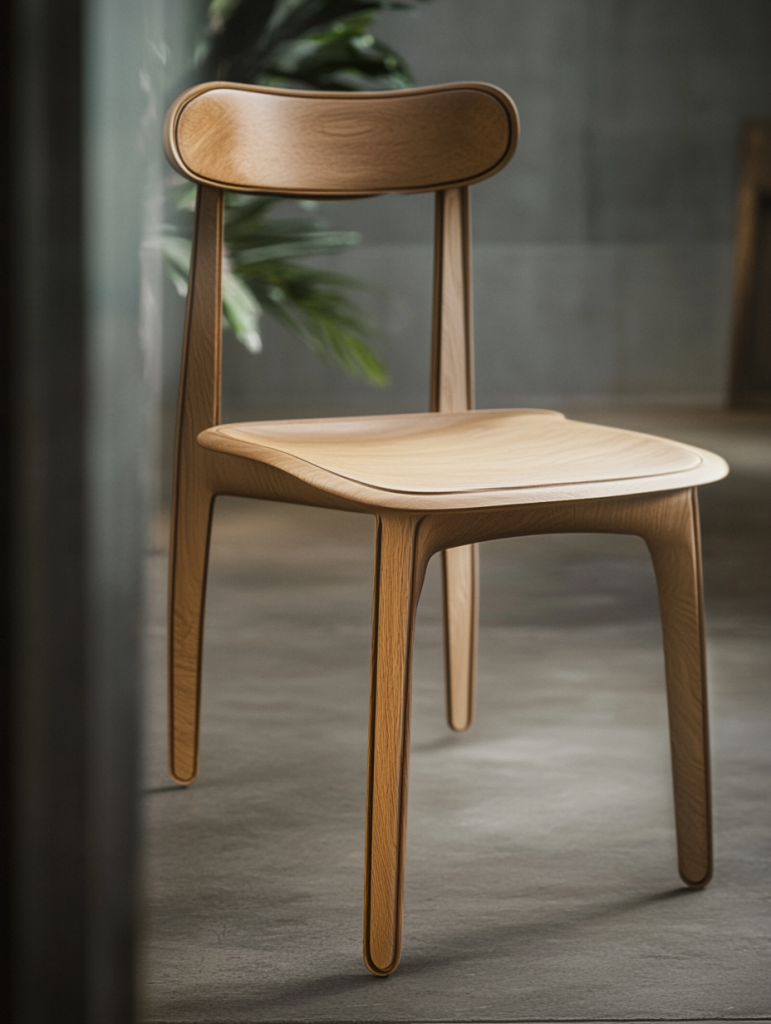
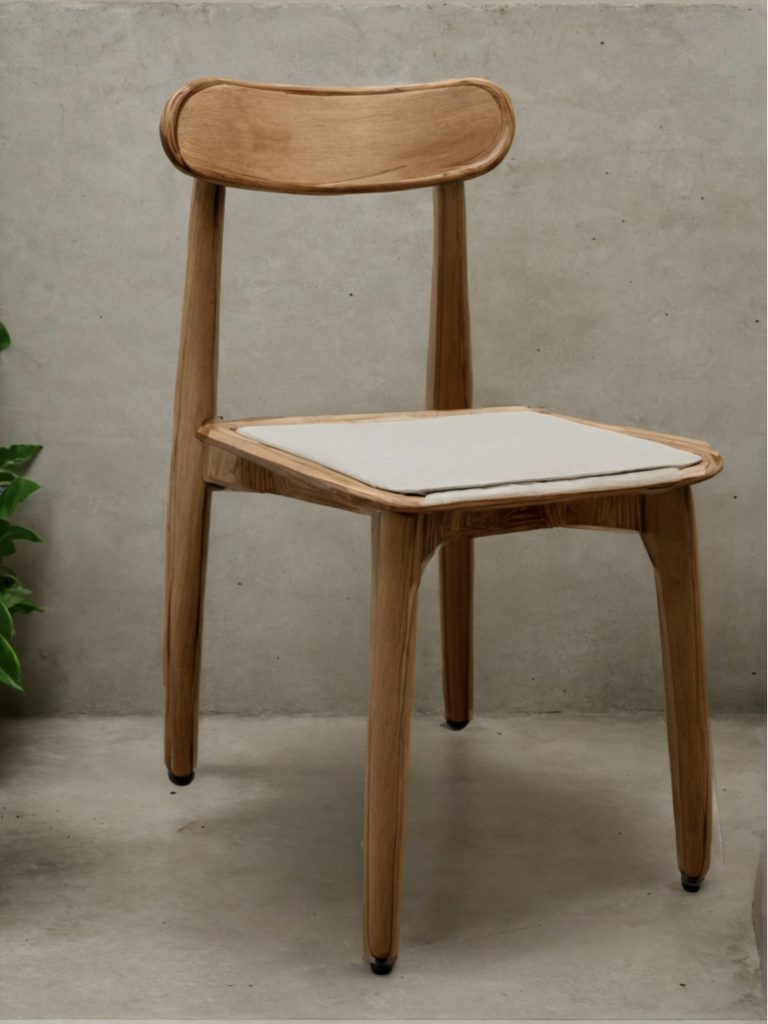
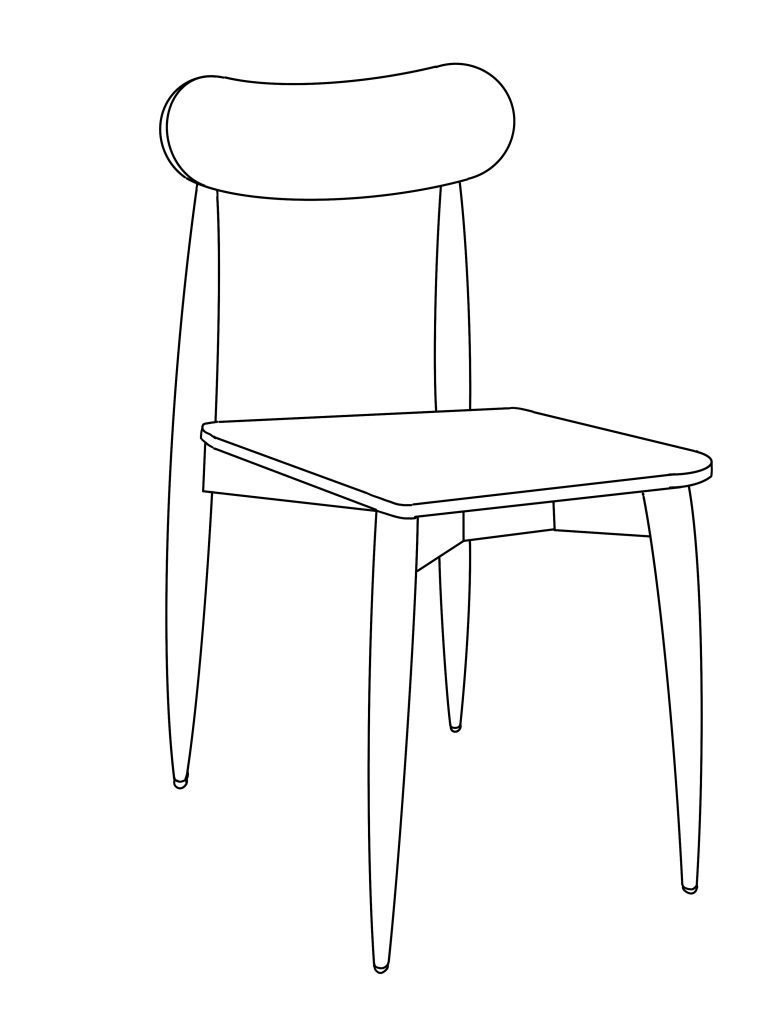
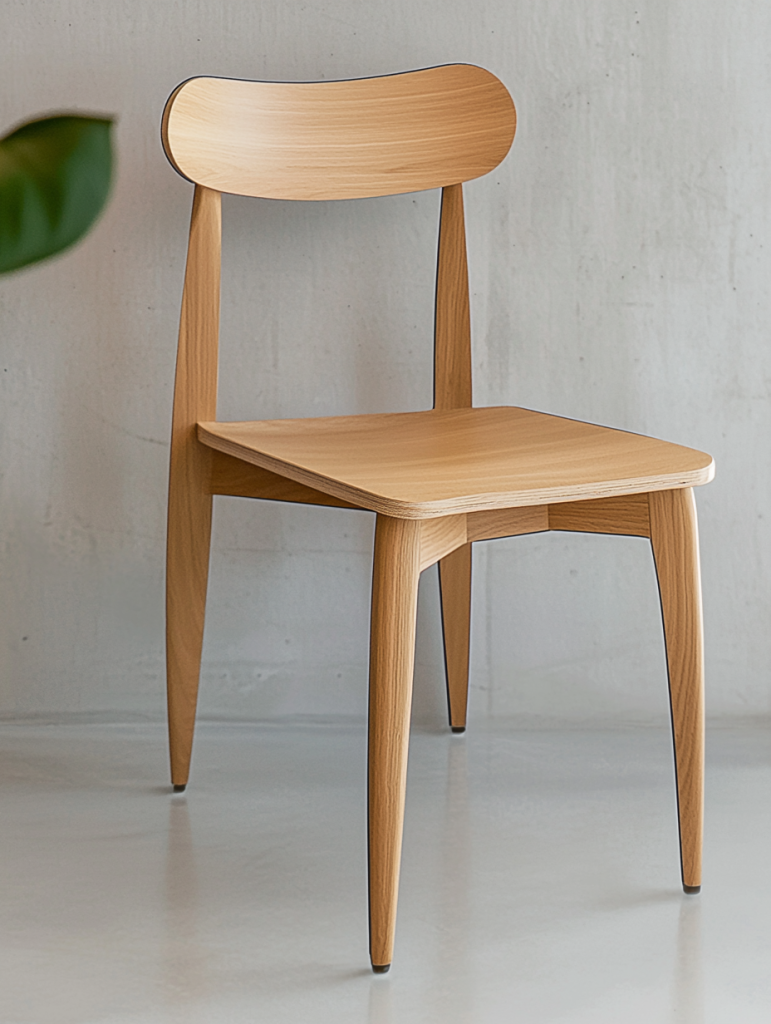
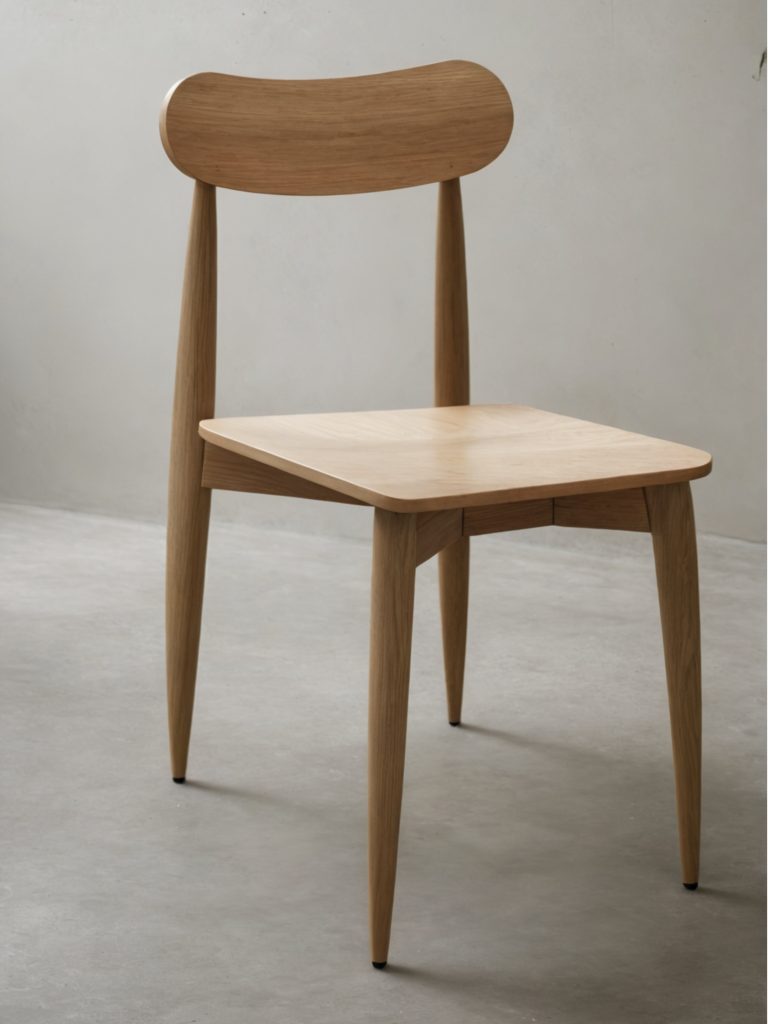
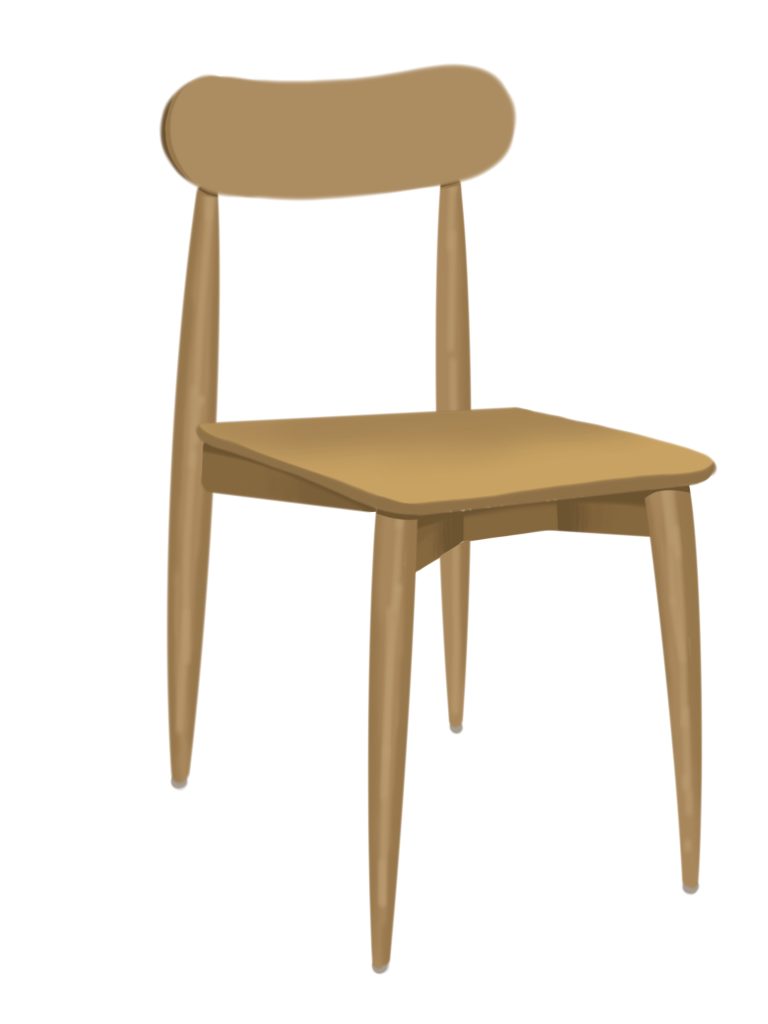
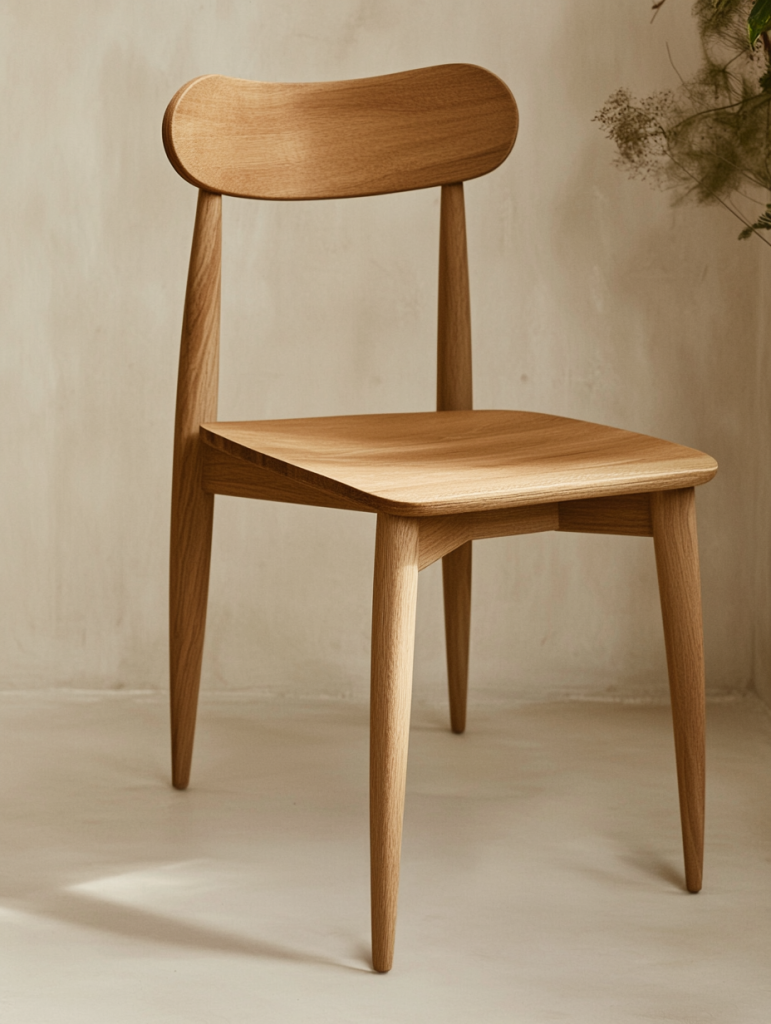
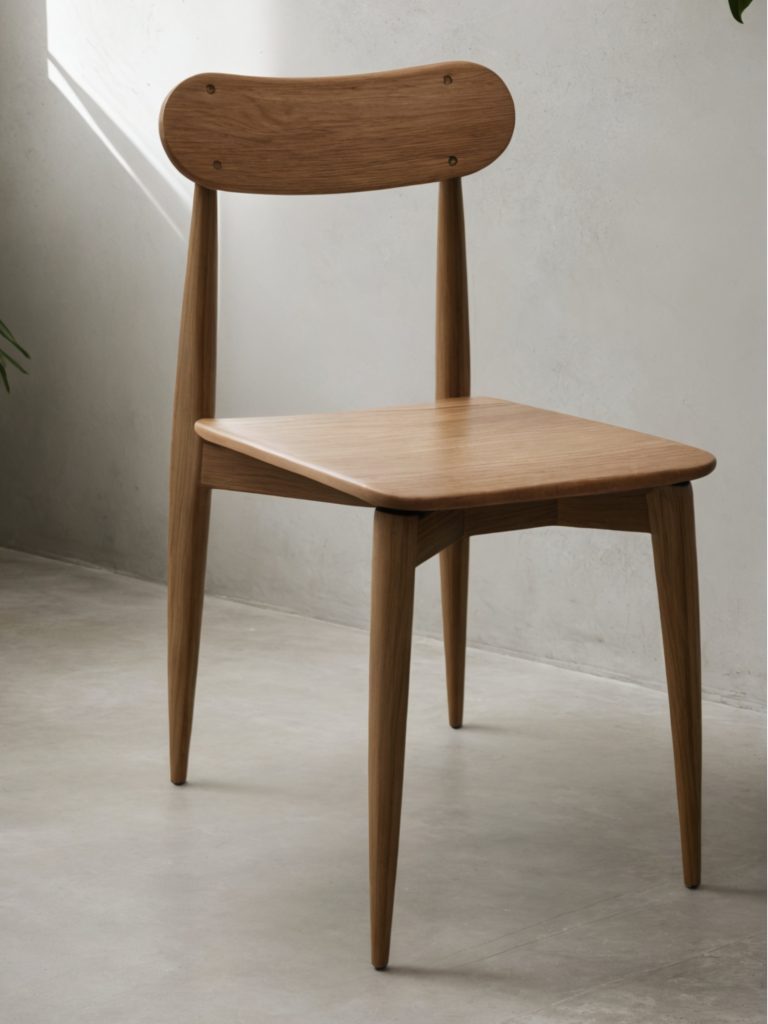
Vamos a partir de un ejemplo sencillo: una silla. Además de servirnos para ilustrar el concepto, nos permitirá comparar estos resultados con los obtenidos en la sección dedicada al prompt.

En este caso, proporcionaremos a la IA tres imágenes de control para ver cómo las interpreta y transforma. Conviene tener en cuenta que cada modelo de IA funciona de forma distinta, por lo que los resultados pueden variar considerablemente según el motor que utilicemos y los parámetros que configuremos.

Imagen de control
Midjourney
Vizcom
Imagen de control
Midjourney
Vizcom
Imagen de control
Midjourney
Vizcom

Podemos llegar a la conclusión de que, cuando se mantiene la influencia de la imagen de control al 100% para que respete al máximo nuestro diseño, el boceto puramente manual no ofrece buenos resultados.

En cambio, la línea pura funciona muy bien, aunque el resultado puede percibirse como algo «sintético» o rígido.

Por su parte, la versión sombreada transmite mejor el trabajo artístico original, aportando profundidad y matices. Es, probablemente, la que ofrece un equilibrio más eficaz entre fidelidad al diseño y calidad visual.

Subiendo el nivel de complejidad

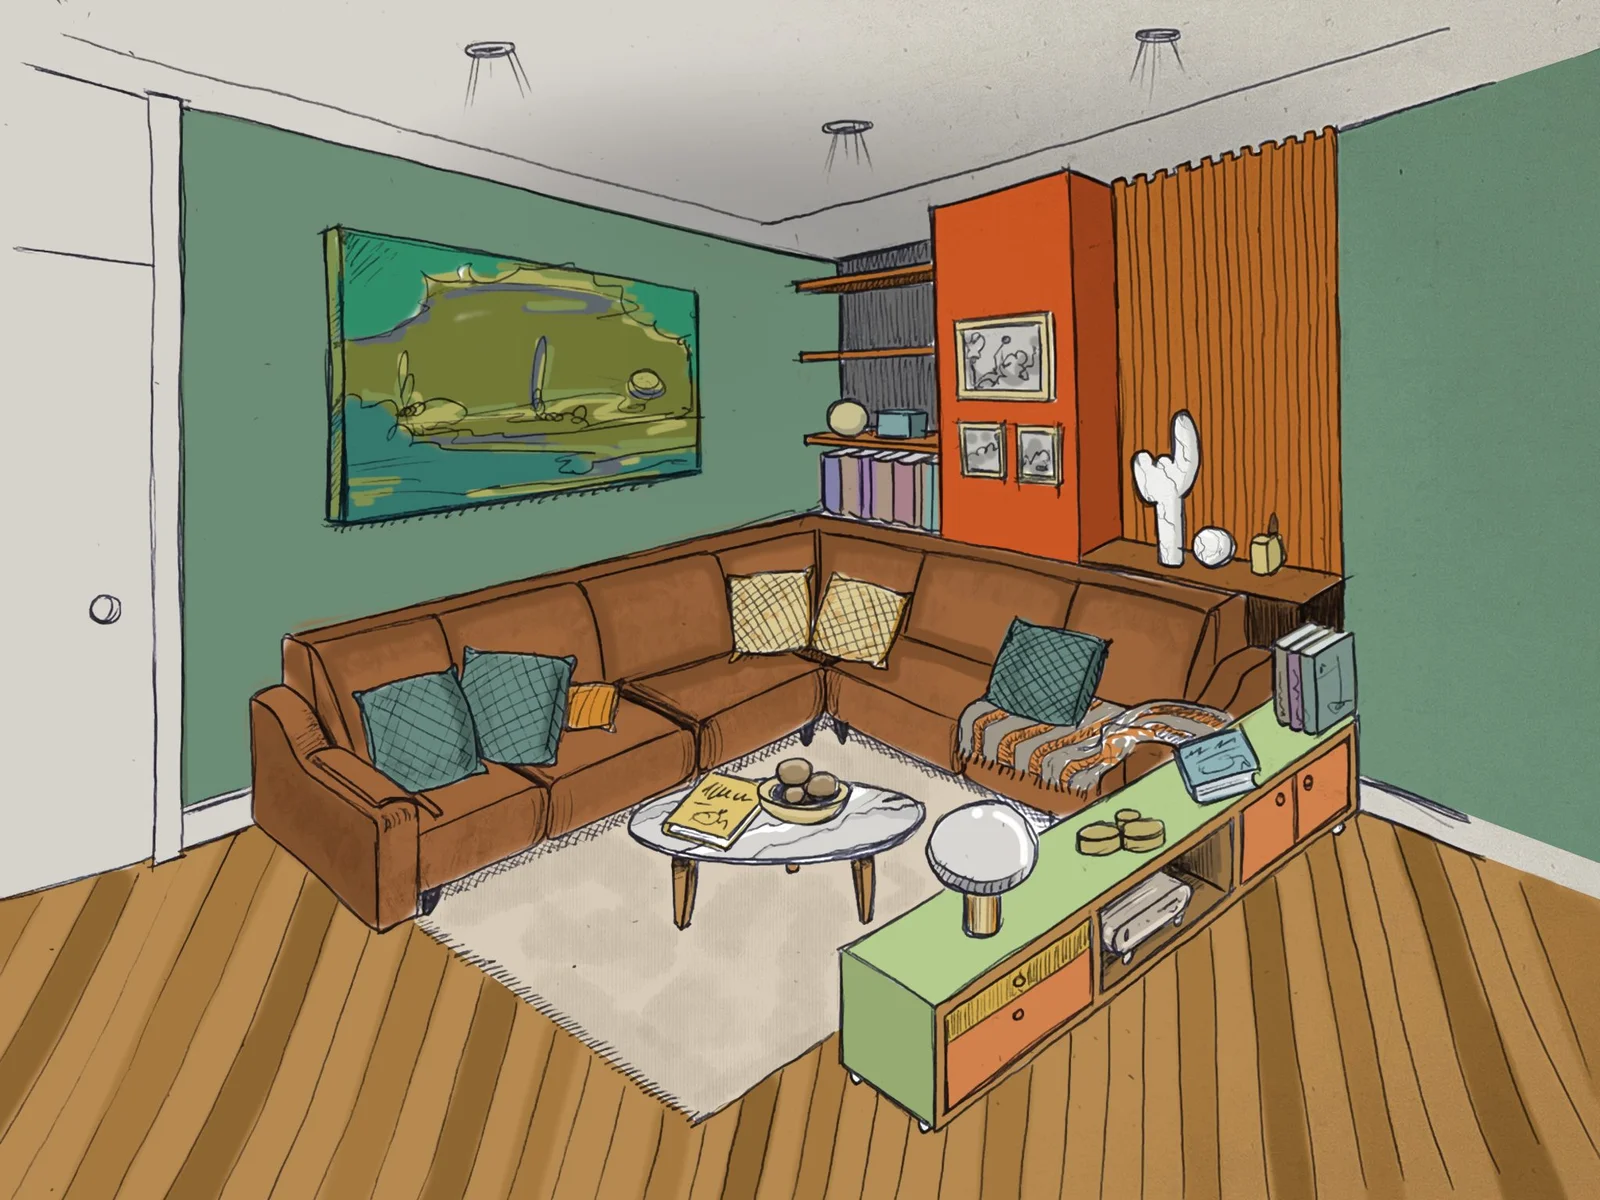
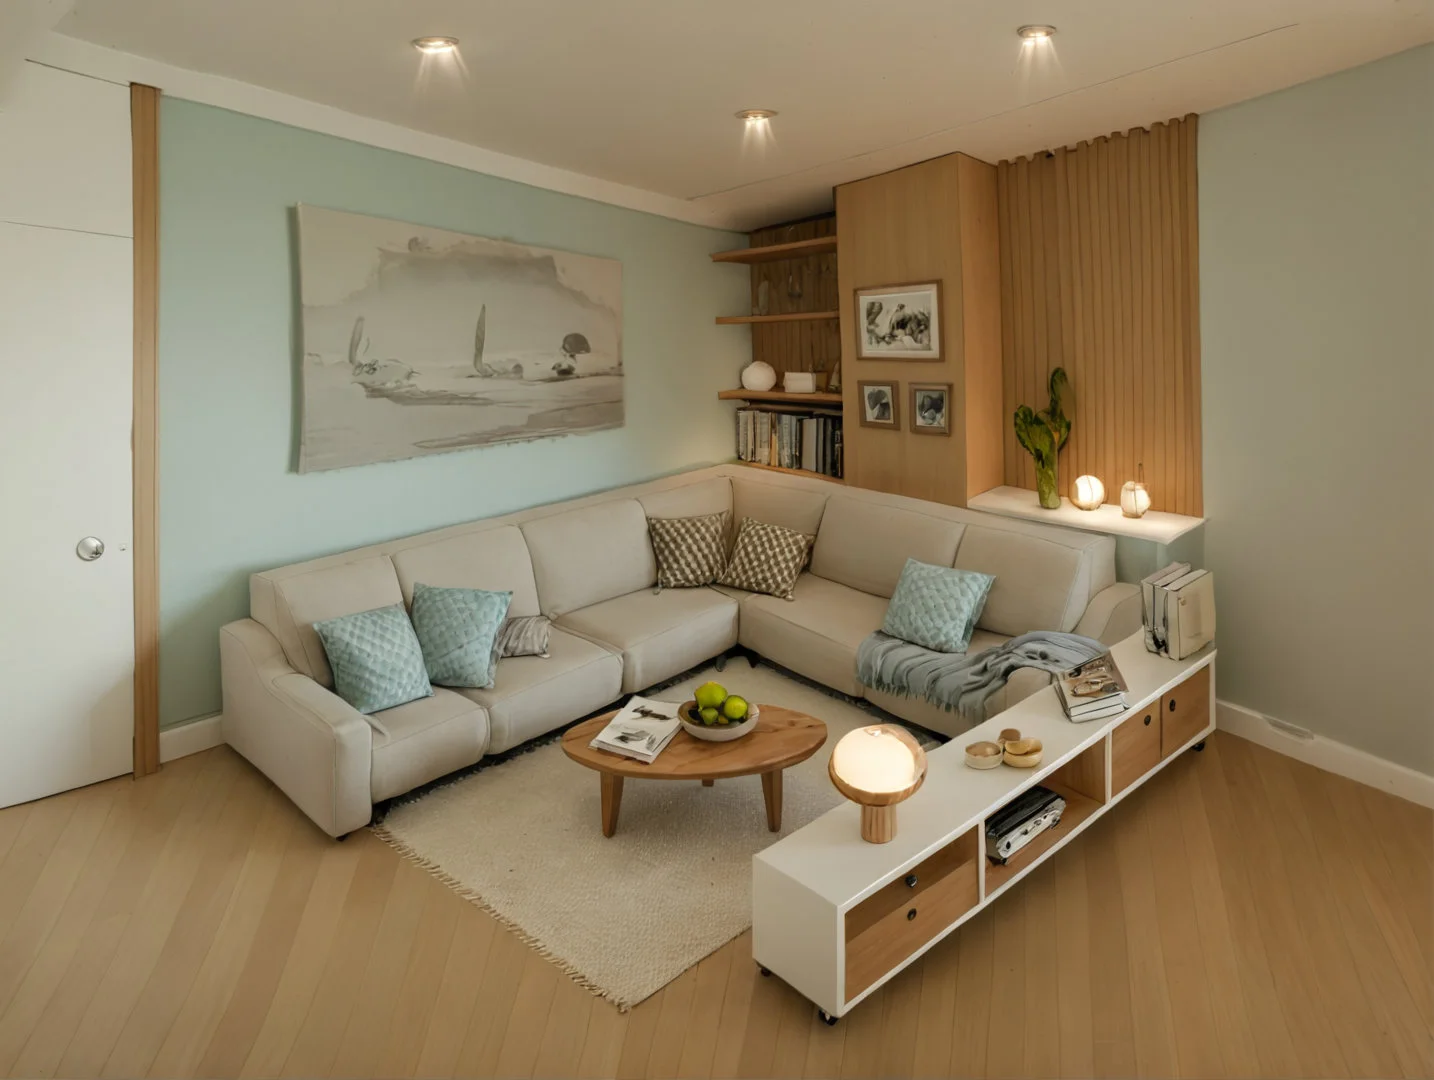
Veamos ahora un ejemplo similar al de la silla, pero aplicado a un interior de vivienda: el rincón de un salón.
Se trata de una escena algo más elaborada, aunque sigue siendo un boceto a mano alzada. En esta ocasión, compararemos una versión coloreada del dibujo, que puede ayudar al modelo a identificar mejor las zonas, los objetos y los volúmenes.


Para el experimento utilizamos el mismo prompt y el mismo nivel de influencia en la imagen de control (100%), y comparamos los resultados entre Midjourney y Vizcom.
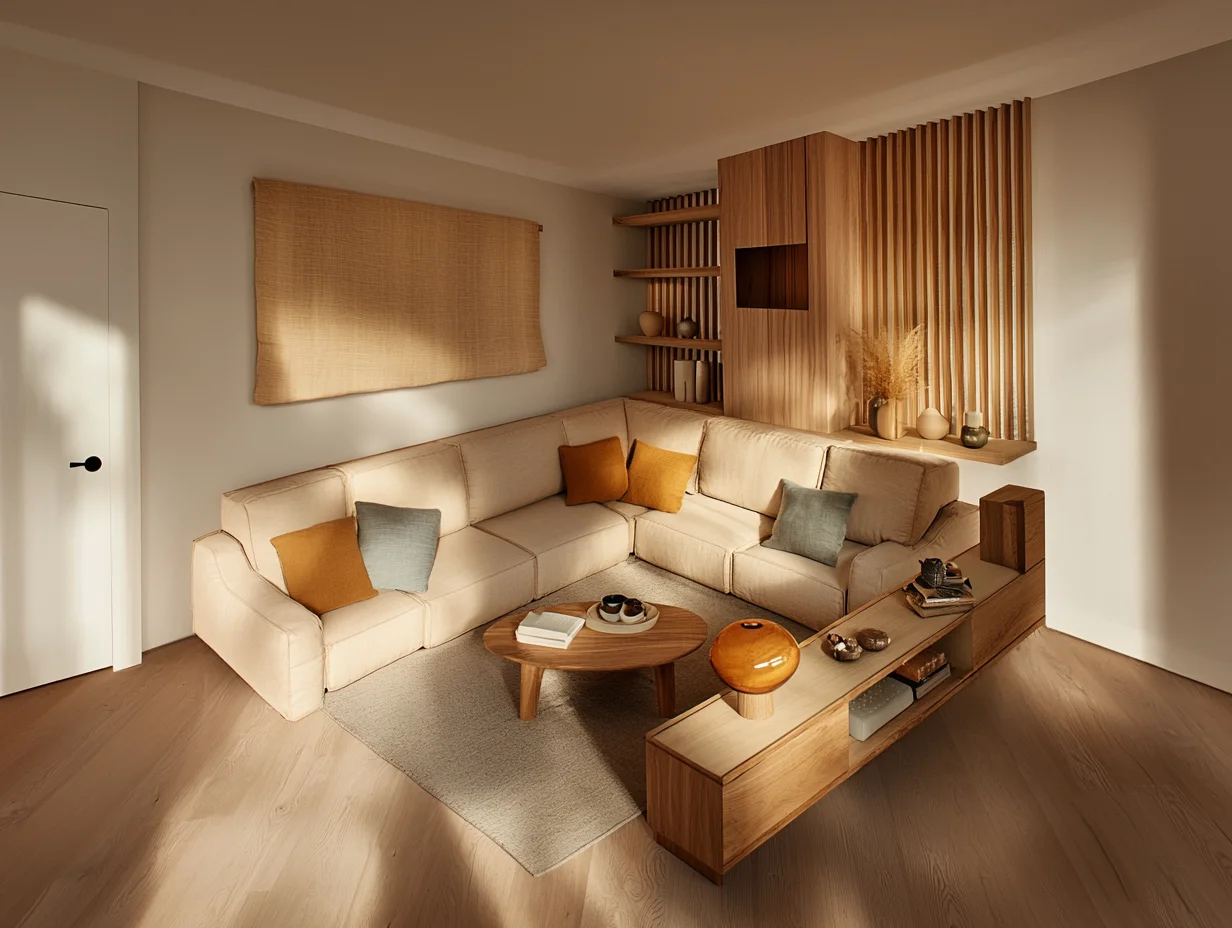
¿Hasta qué punto logran interpretar correctamente nuestra intención? Aquí puedes verlo.

En este caso, Midjourney realiza un buen trabajo interpretando el prompt, que describe un estilo nórdico.
Sin embargo, se aprecian ciertas modificaciones respecto al boceto original, ya que algunos elementos son reinterpretados o sustituidos, lo que refleja las libertades que el modelo se toma incluso con la imagen de control al 100%.

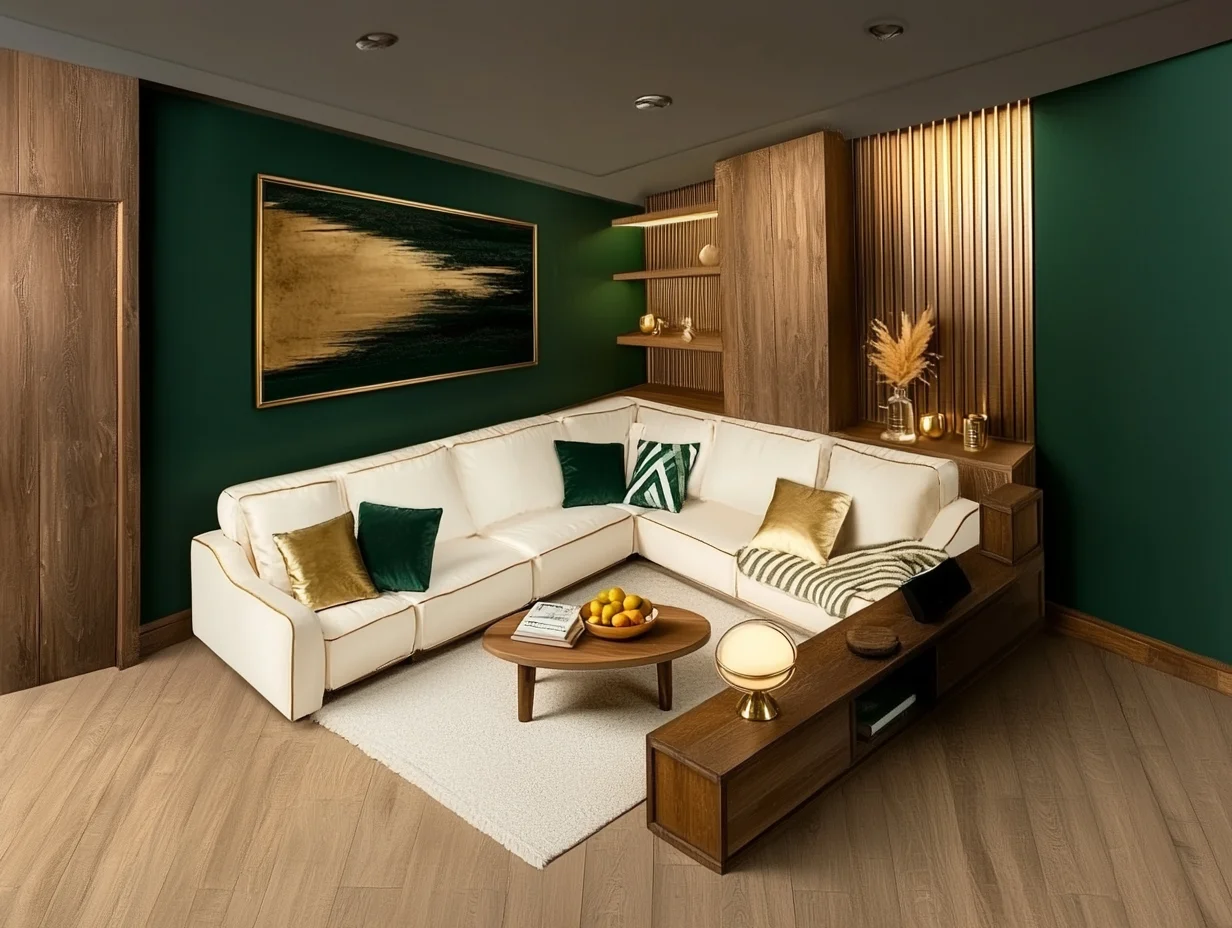
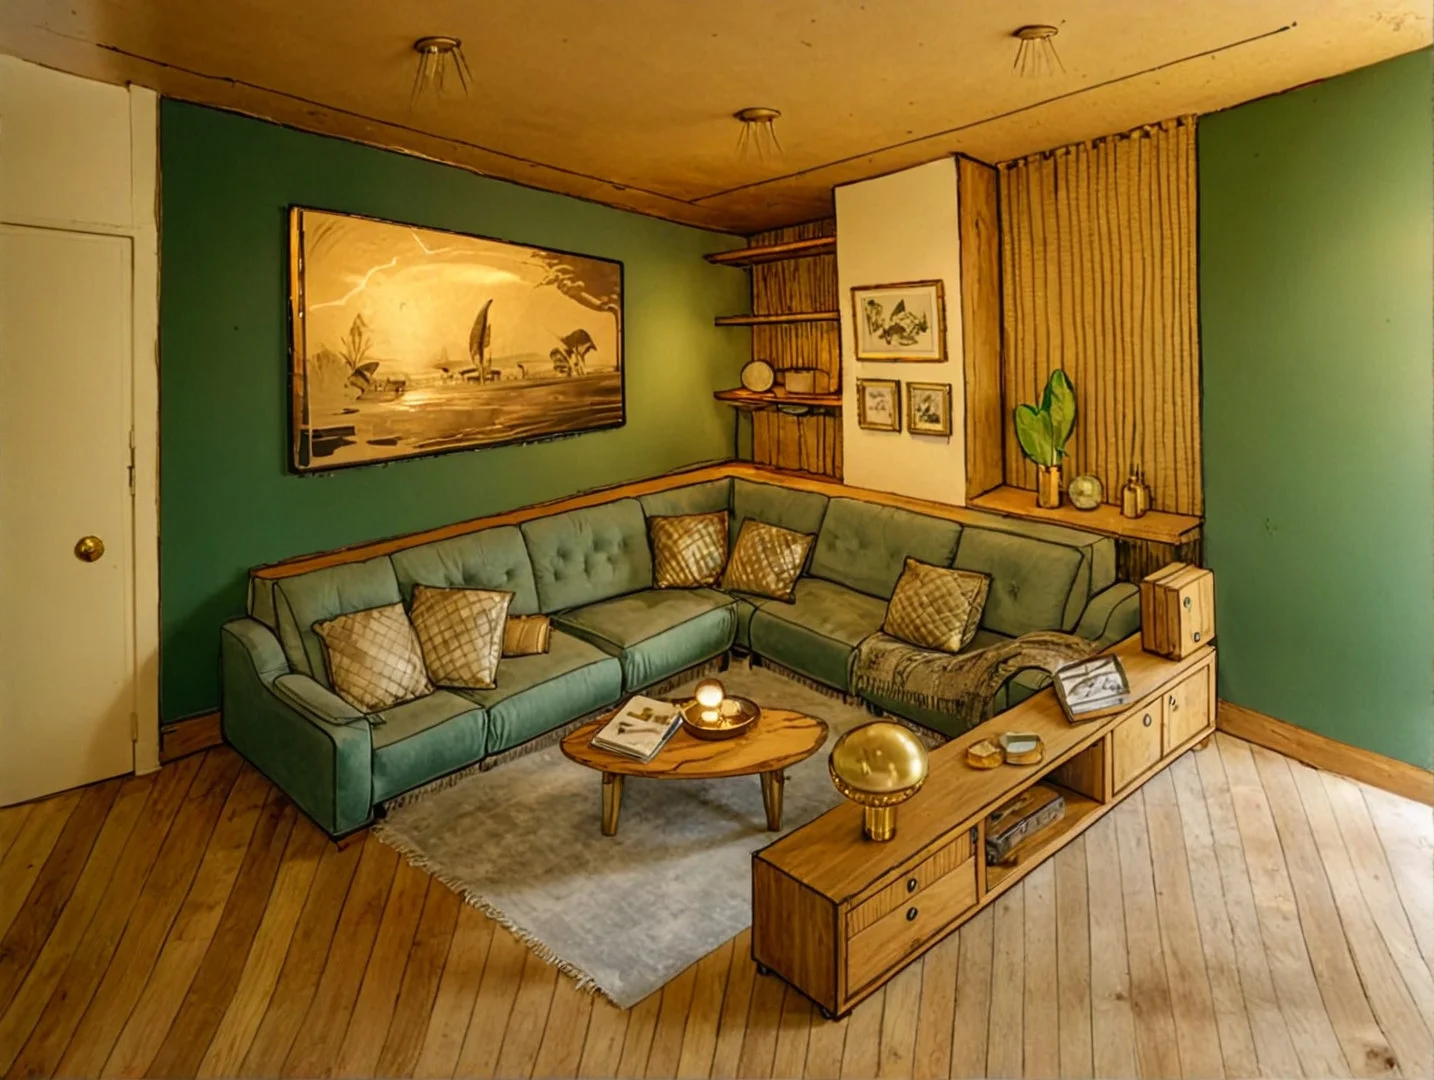
Aquí vemos cómo Midjourney vuelve a ofrecer un resultado sólido.
A pesar de mantener el mismo prompt enfocado en un estilo nórdico, al añadir una imagen de control para el estilo, el modelo se adapta con precisión a la referencia visual, logrando una fusión muy coherente entre el contenido del prompt y la estética de la imagen proporcionada.

Ahora es Vizcom quien se pone a prueba, y aunque los resultados son algo más discretos en cuanto al estilo, se aprecia claramente cómo respeta de forma mucho más precisa la estructura y proporciones del dibujo original. Un ejemplo claro de cómo la fidelidad estructural puede prevalecer sobre la estética, dependiendo del modelo que utilicemos.

En esta prueba, al incorporar una imagen como control de estilo, por desgracia Vizcom no termina de dar la talla. El modelo intenta una fusión forzada entre boceto y estilo, y el resultado final no alcanza un nivel aceptable. Es cierto que, con ajustes finos y probando diferentes combinaciones de parámetros, podríamos lograr una mejora notable. Sin embargo, aplicando exactamente los mismos parámetros que en otras pruebas, el desempeño en este caso es claramente inferior.

3D

¿Es el 3D una opción?

Sí, pero depende.

El 3D tiene una ventaja indiscutible: el control absoluto sobre el resultado final. Permite definir con precisión la geometría, los materiales, los colores, la iluminación… y eso lo convierte en una herramienta insustituible en muchos procesos técnicos y productivos.

Ahora bien, cuando hablamos de representar ideas de forma ágil, para comunicar una propuesta de forma rápida o explorar alternativas con poco margen de tiempo, las reglas cambian.

El modelado 3D sigue exigiendo herramientas complejas, tiempos de trabajo prolongados y equipos potentes. Por eso, cuando lo que se busca es agilidad —para un primer contacto, una fase inicial o una presentación preliminar—, puede que no sea siempre la opción más eficiente.

Imaginemos dos escenarios posibles:

– En el primero, se genera un modelo 3D básico, sin texturas, que se reinterpreta a través de IA. El resultado suele ser limitado: la IA aplica estilos y materiales sin demasiado control, lo que a menudo genera inconsistencias similares a las de un boceto rápido a mano.

– En el segundo, se desarrolla un modelo 3D completo, perfectamente texturizado, para después pedirle a la IA que genere variantes. En ese caso, la pregunta es si merece la pena todo ese trabajo previo para acabar delegando el resultado final a un sistema generativo.

¿Tiene sentido el 3D?
Por supuesto. Sigue siendo una herramienta poderosa, especialmente cuando buscamos precisión o cuando forma parte de un flujo de producción más amplio.

Pero a medida que las herramientas de IA evolucionen, y nos ofrezcan un mayor grado de control y coherencia visual, es probable que el papel del 3D cambie. No desaparecerá, pero su uso podría quedar reservado para fases muy concretas del proceso creativo.

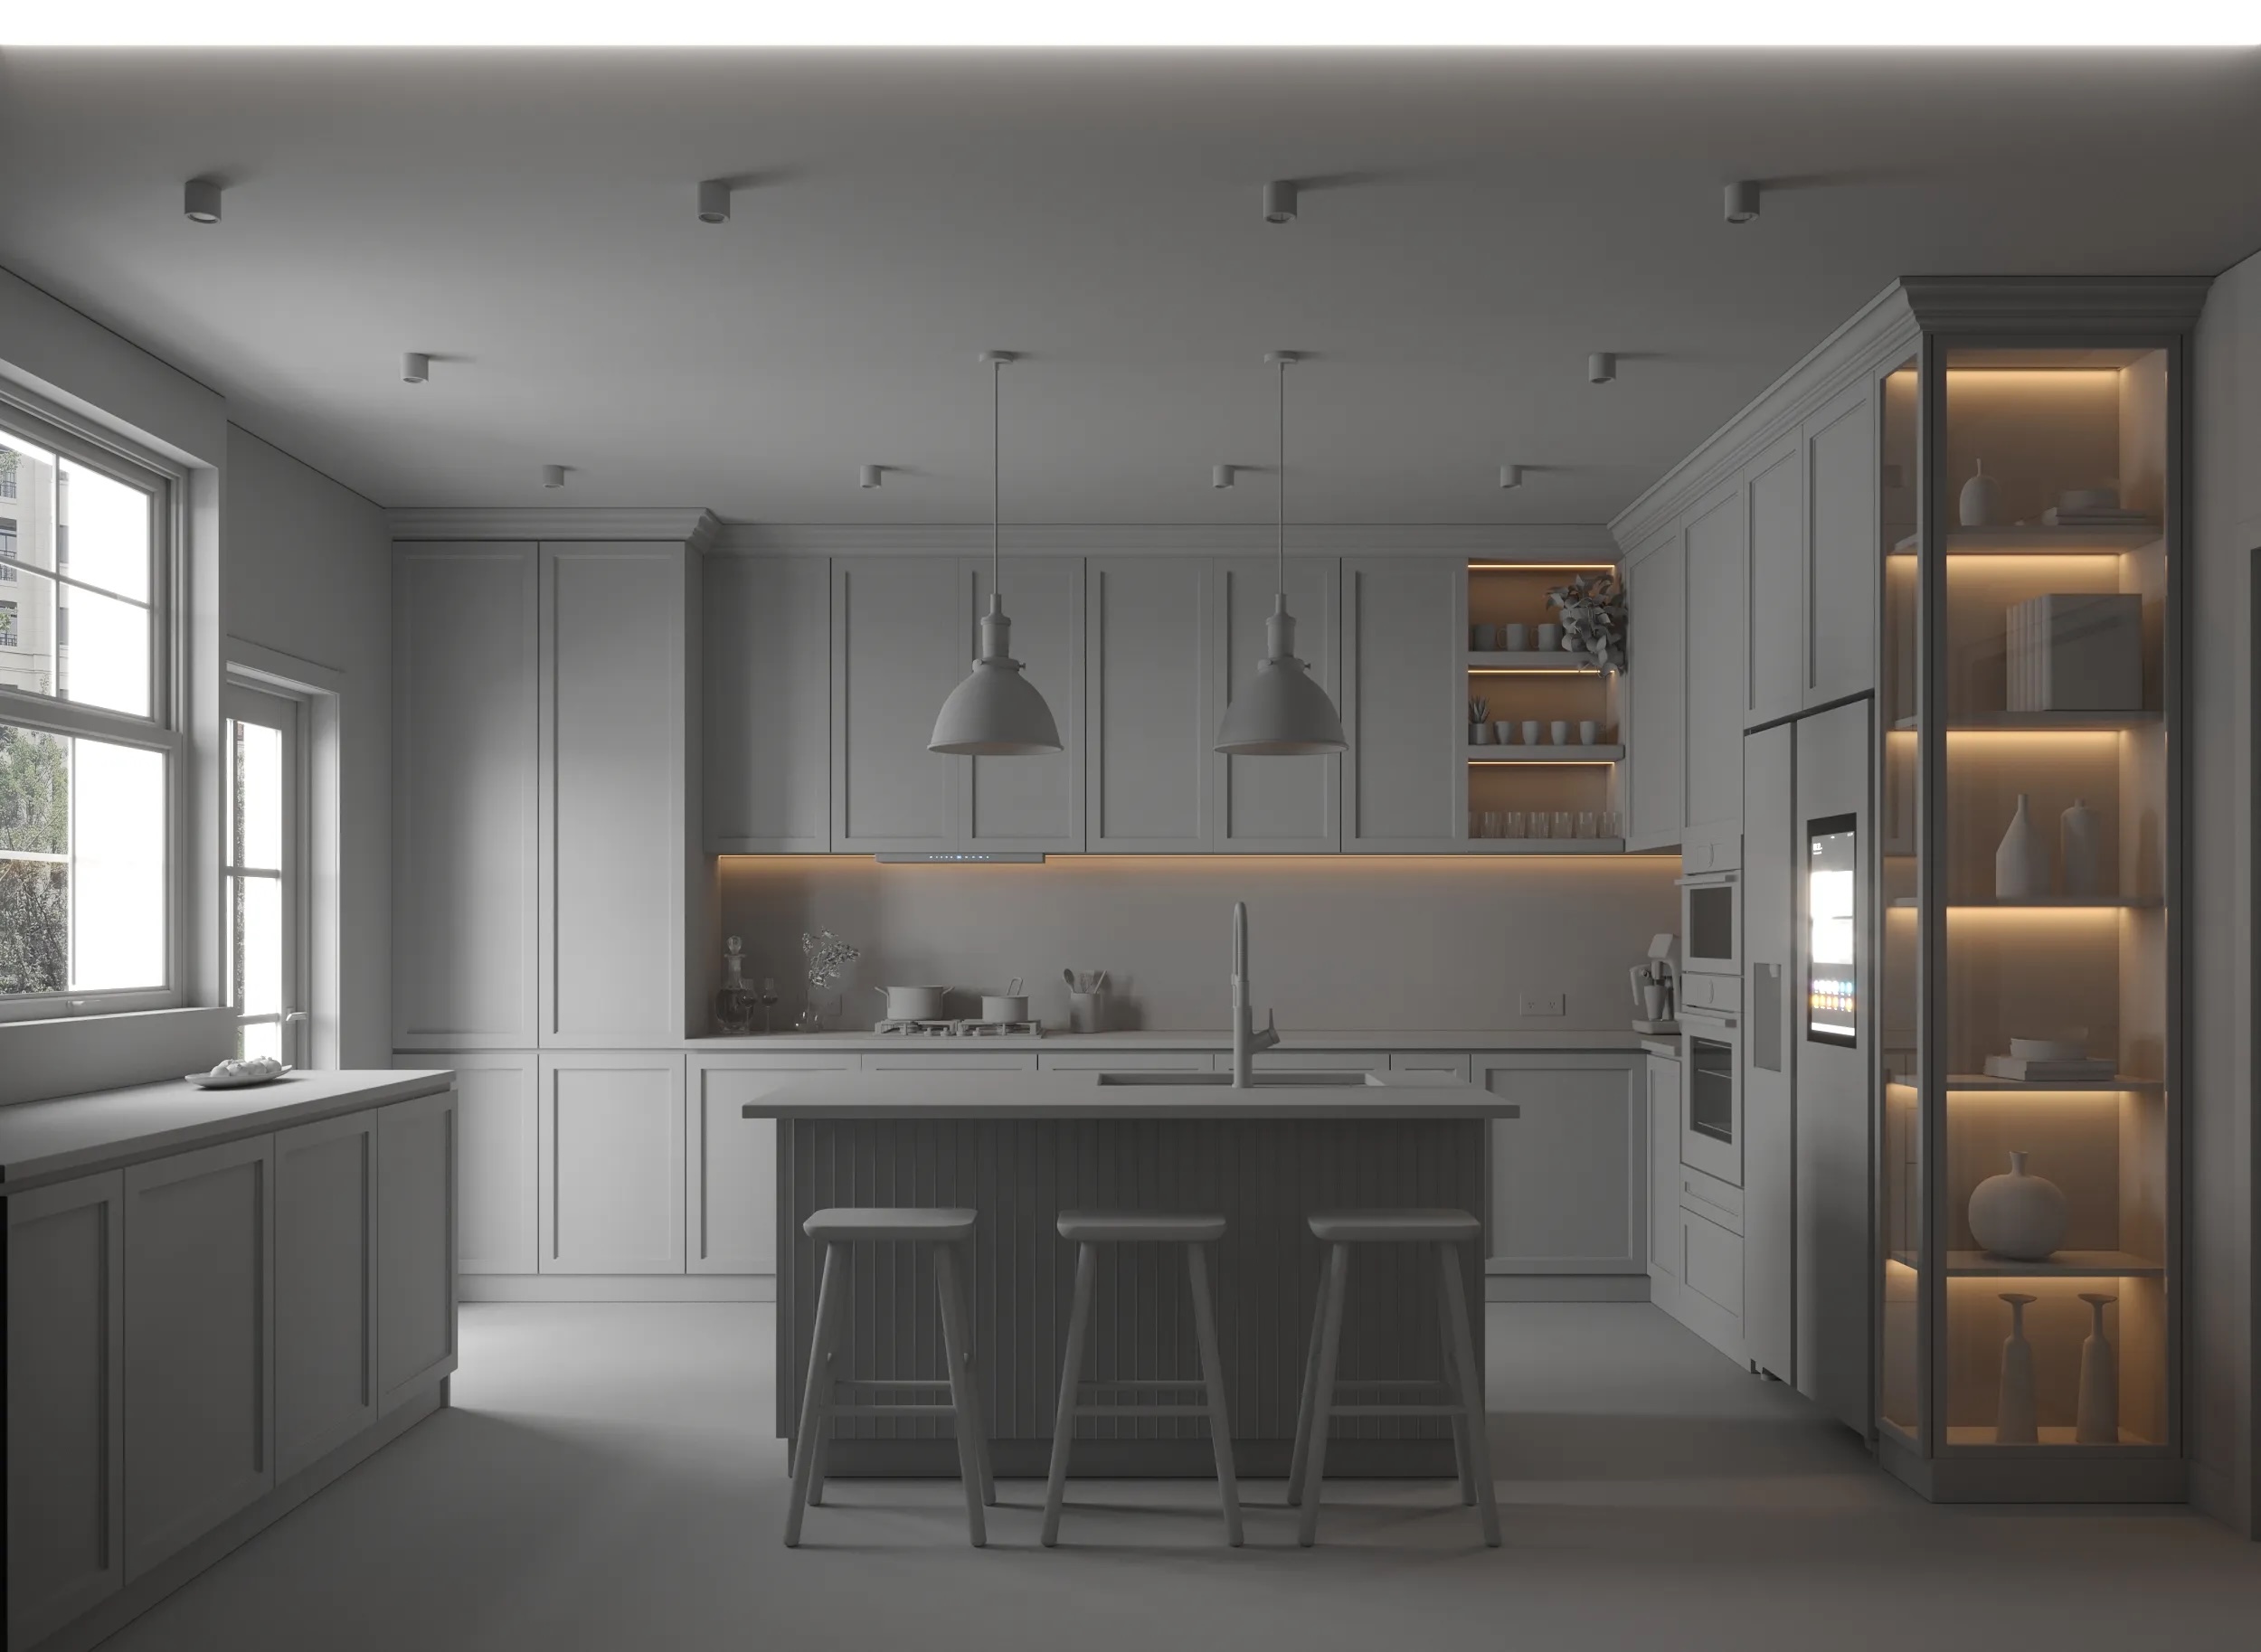
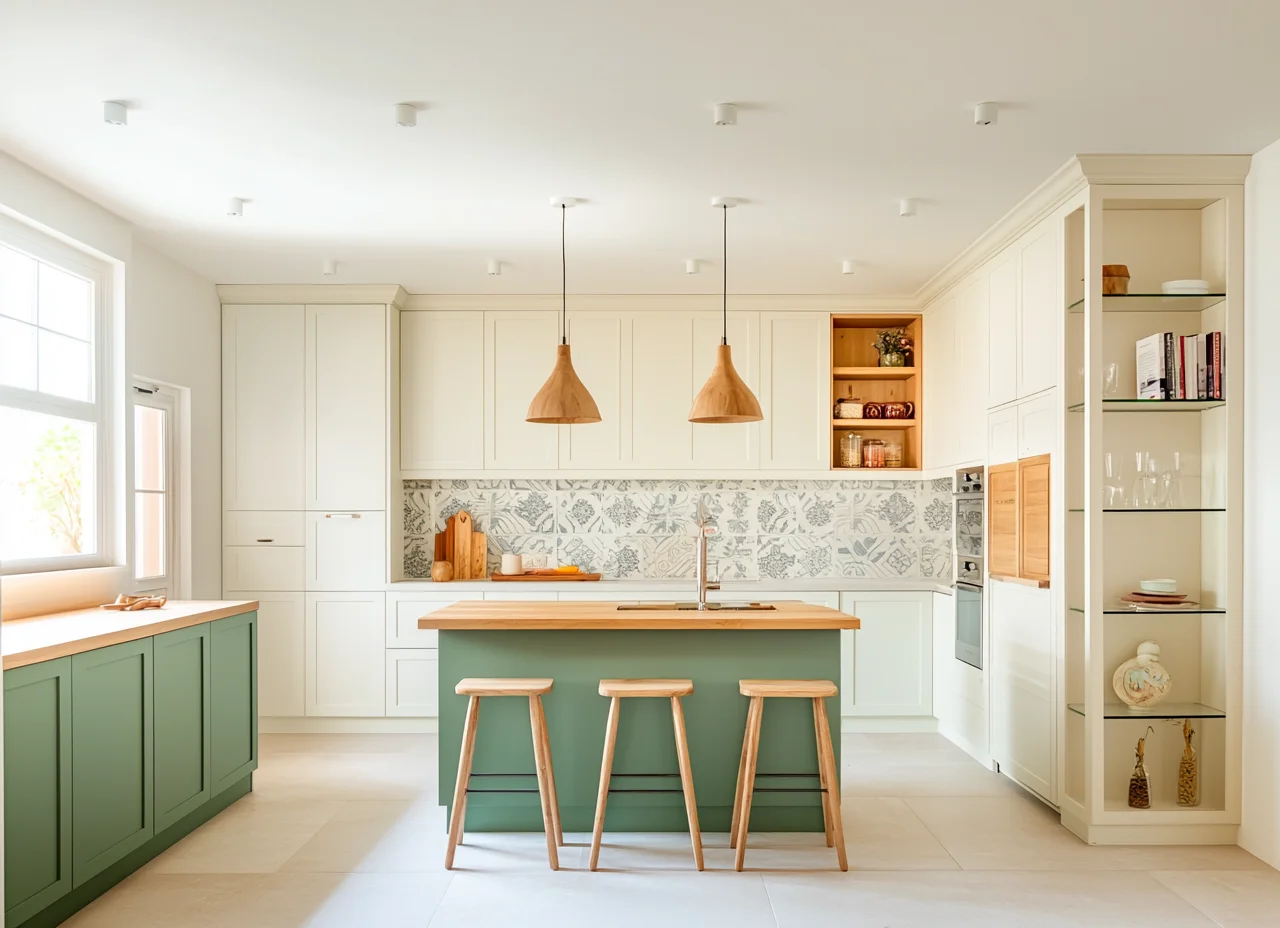
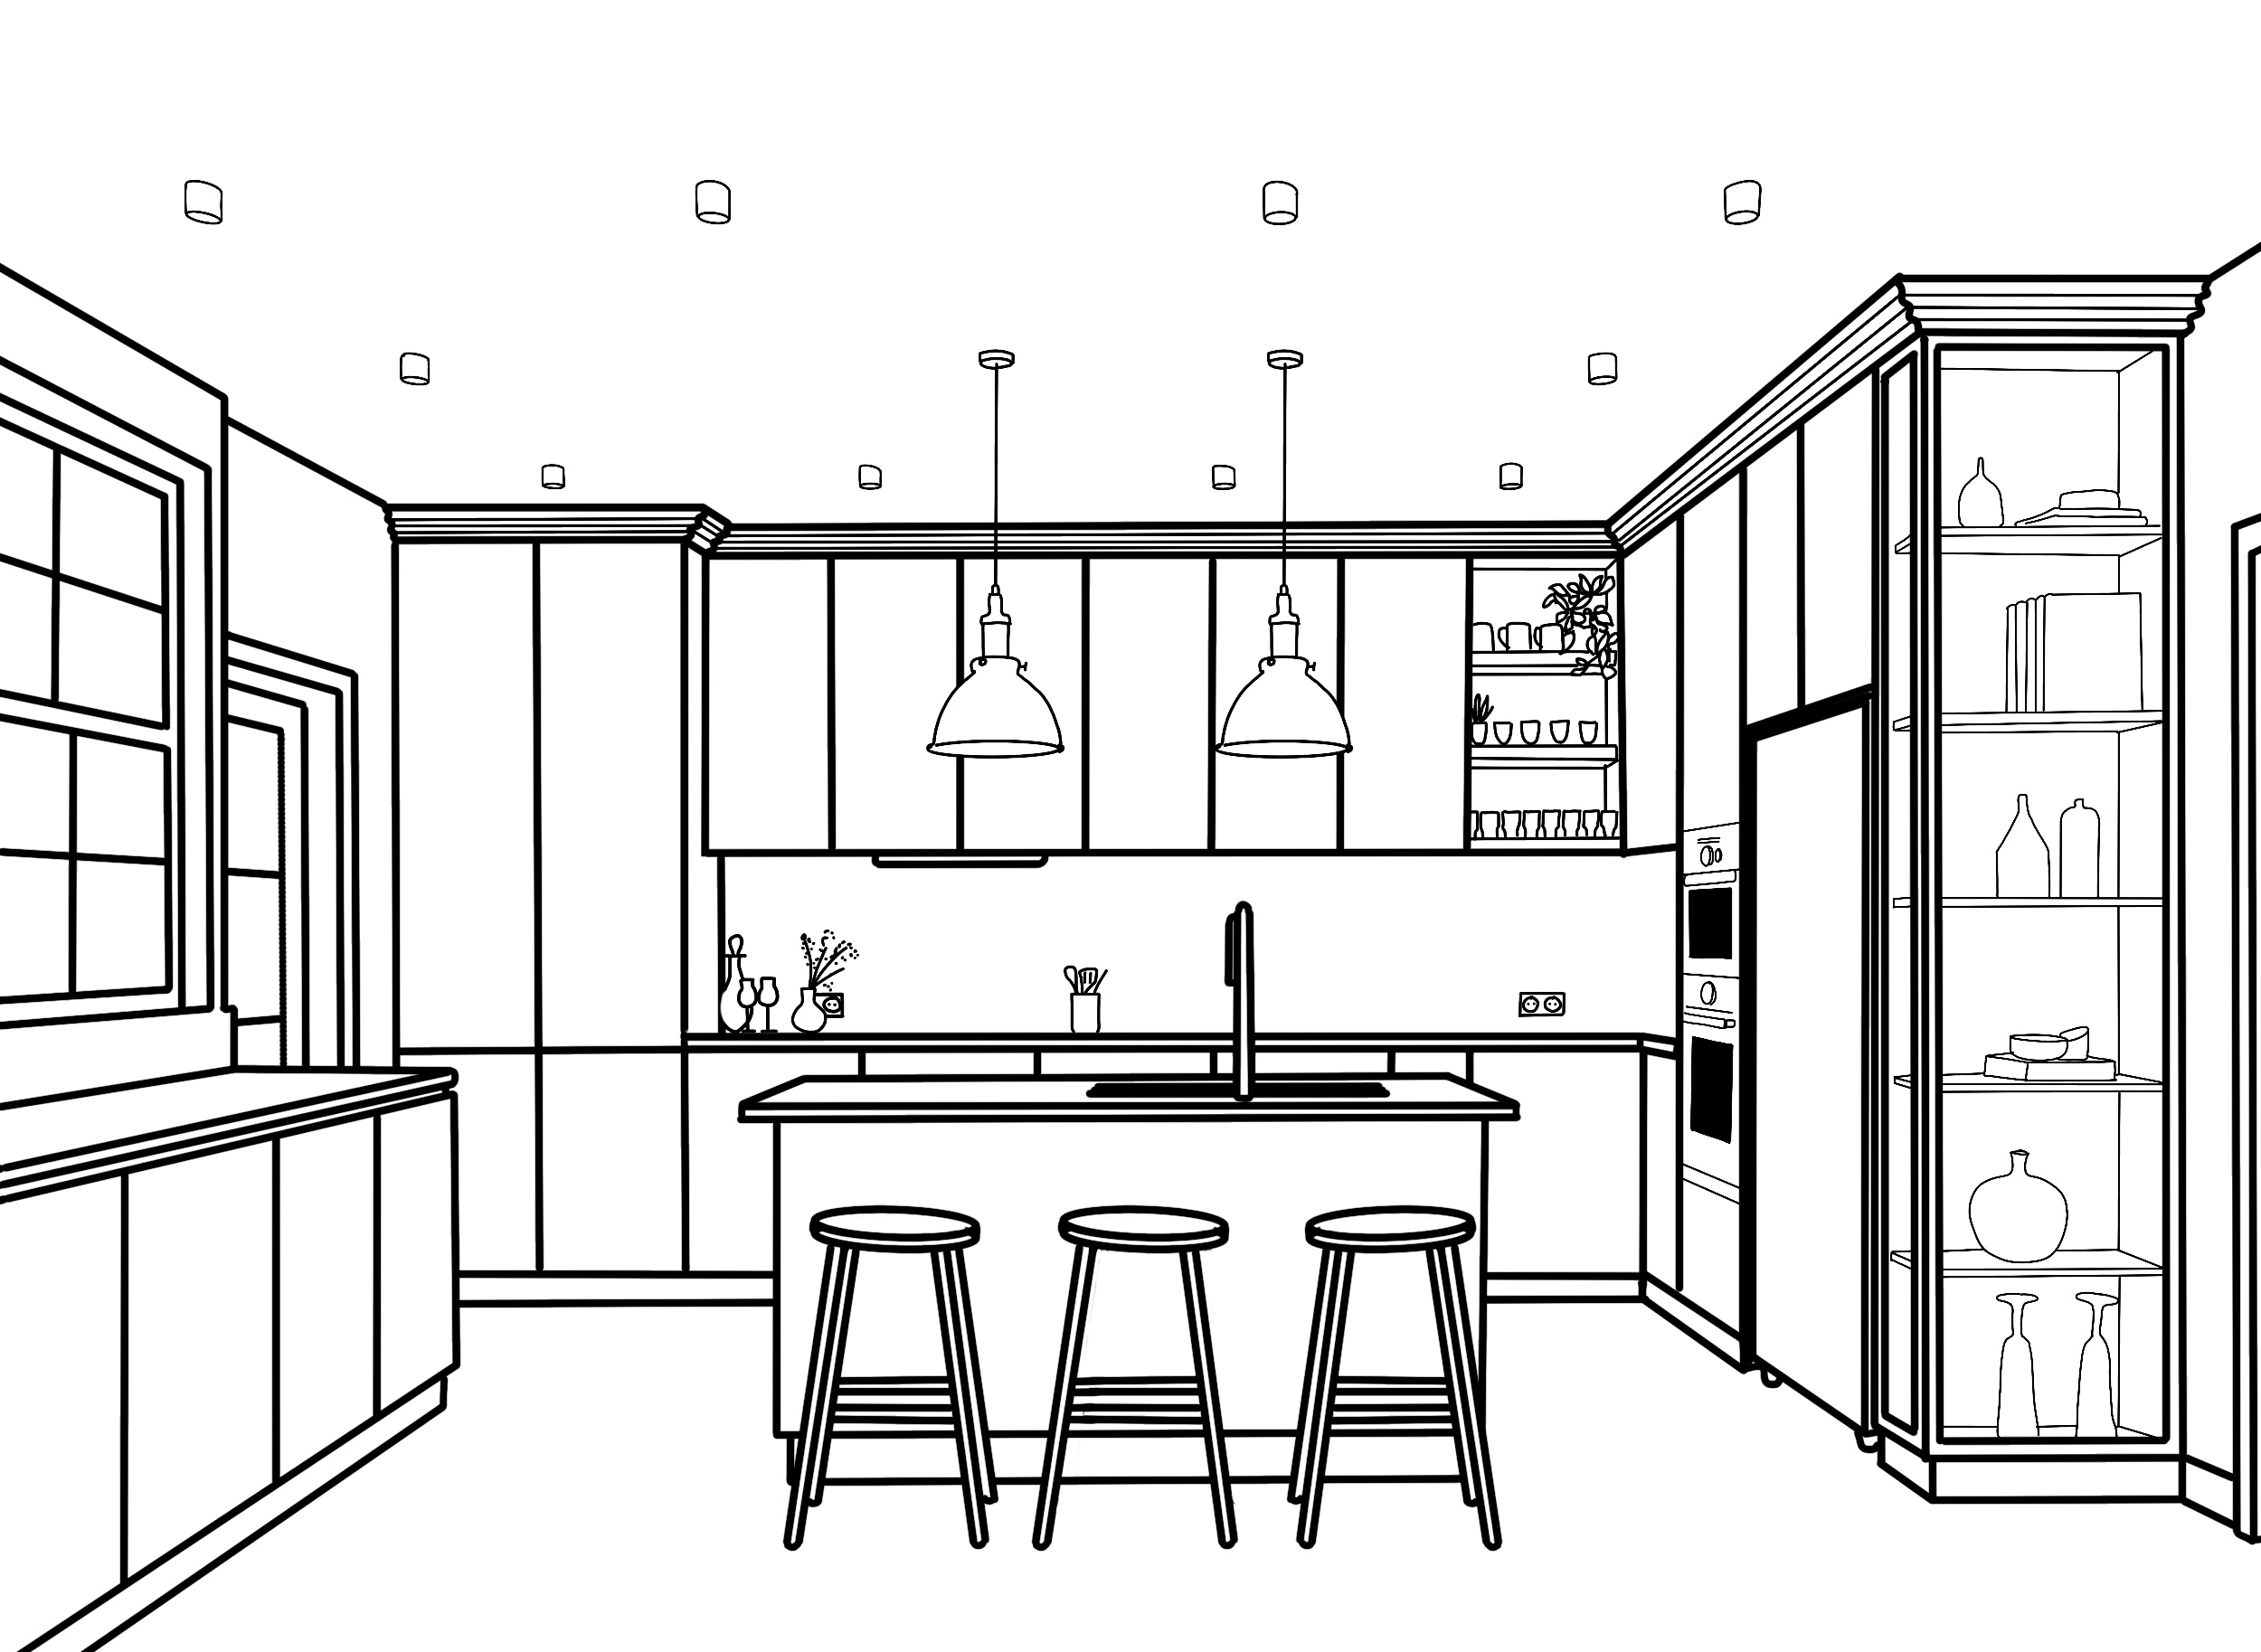
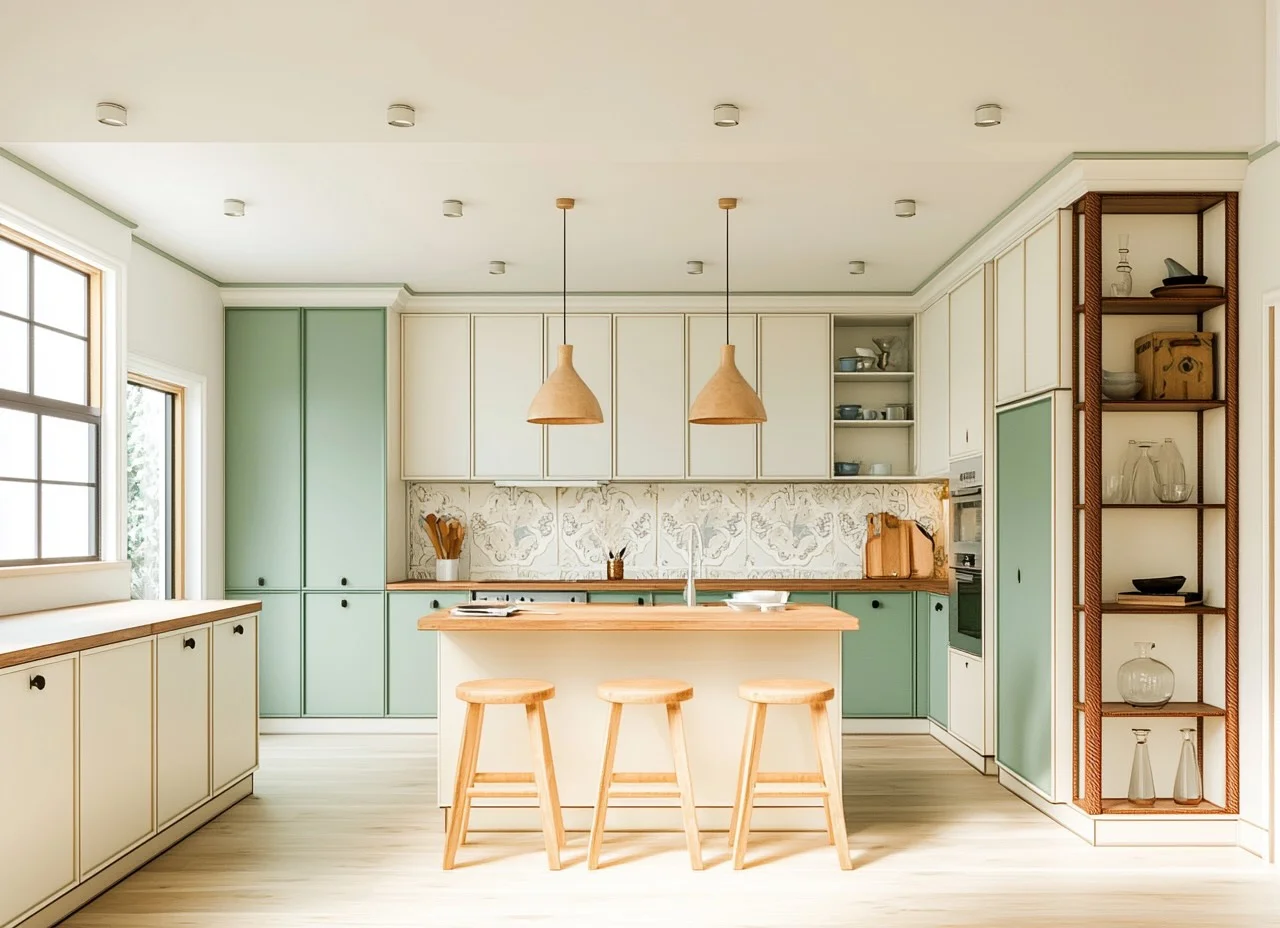
A continuación, veremos un ejemplo: una cocina modelada en 3D, sin texturas, reinterpretada por Midjourney en tres estilos diferentes mediante imágenes de referencia. Y más adelante, compararemos esos mismos resultados con la versión en dibujo lineal.

Este es el resultado de aplicar tres estilos de cocina diferentes a la imagen 3D original, utilizando como referencia fotografías reales y prompts detallados que describen cada propuesta. Una forma visualmente poderosa de explorar variaciones estéticas partiendo de una misma base espacial.

En este caso, el mismo proceso se aplica a la imagen superior, un boceto lineal que replica la vista 3D original. Aunque el resultado es algo menos preciso, pone sobre la mesa el potencial del sistema de transferencia de estilos incluso con inputs más sencillos. Eso sí, invita a replantear algunos ajustes en el flujo de trabajo si se quiere afinar el resultado final.

Más opciones 3D

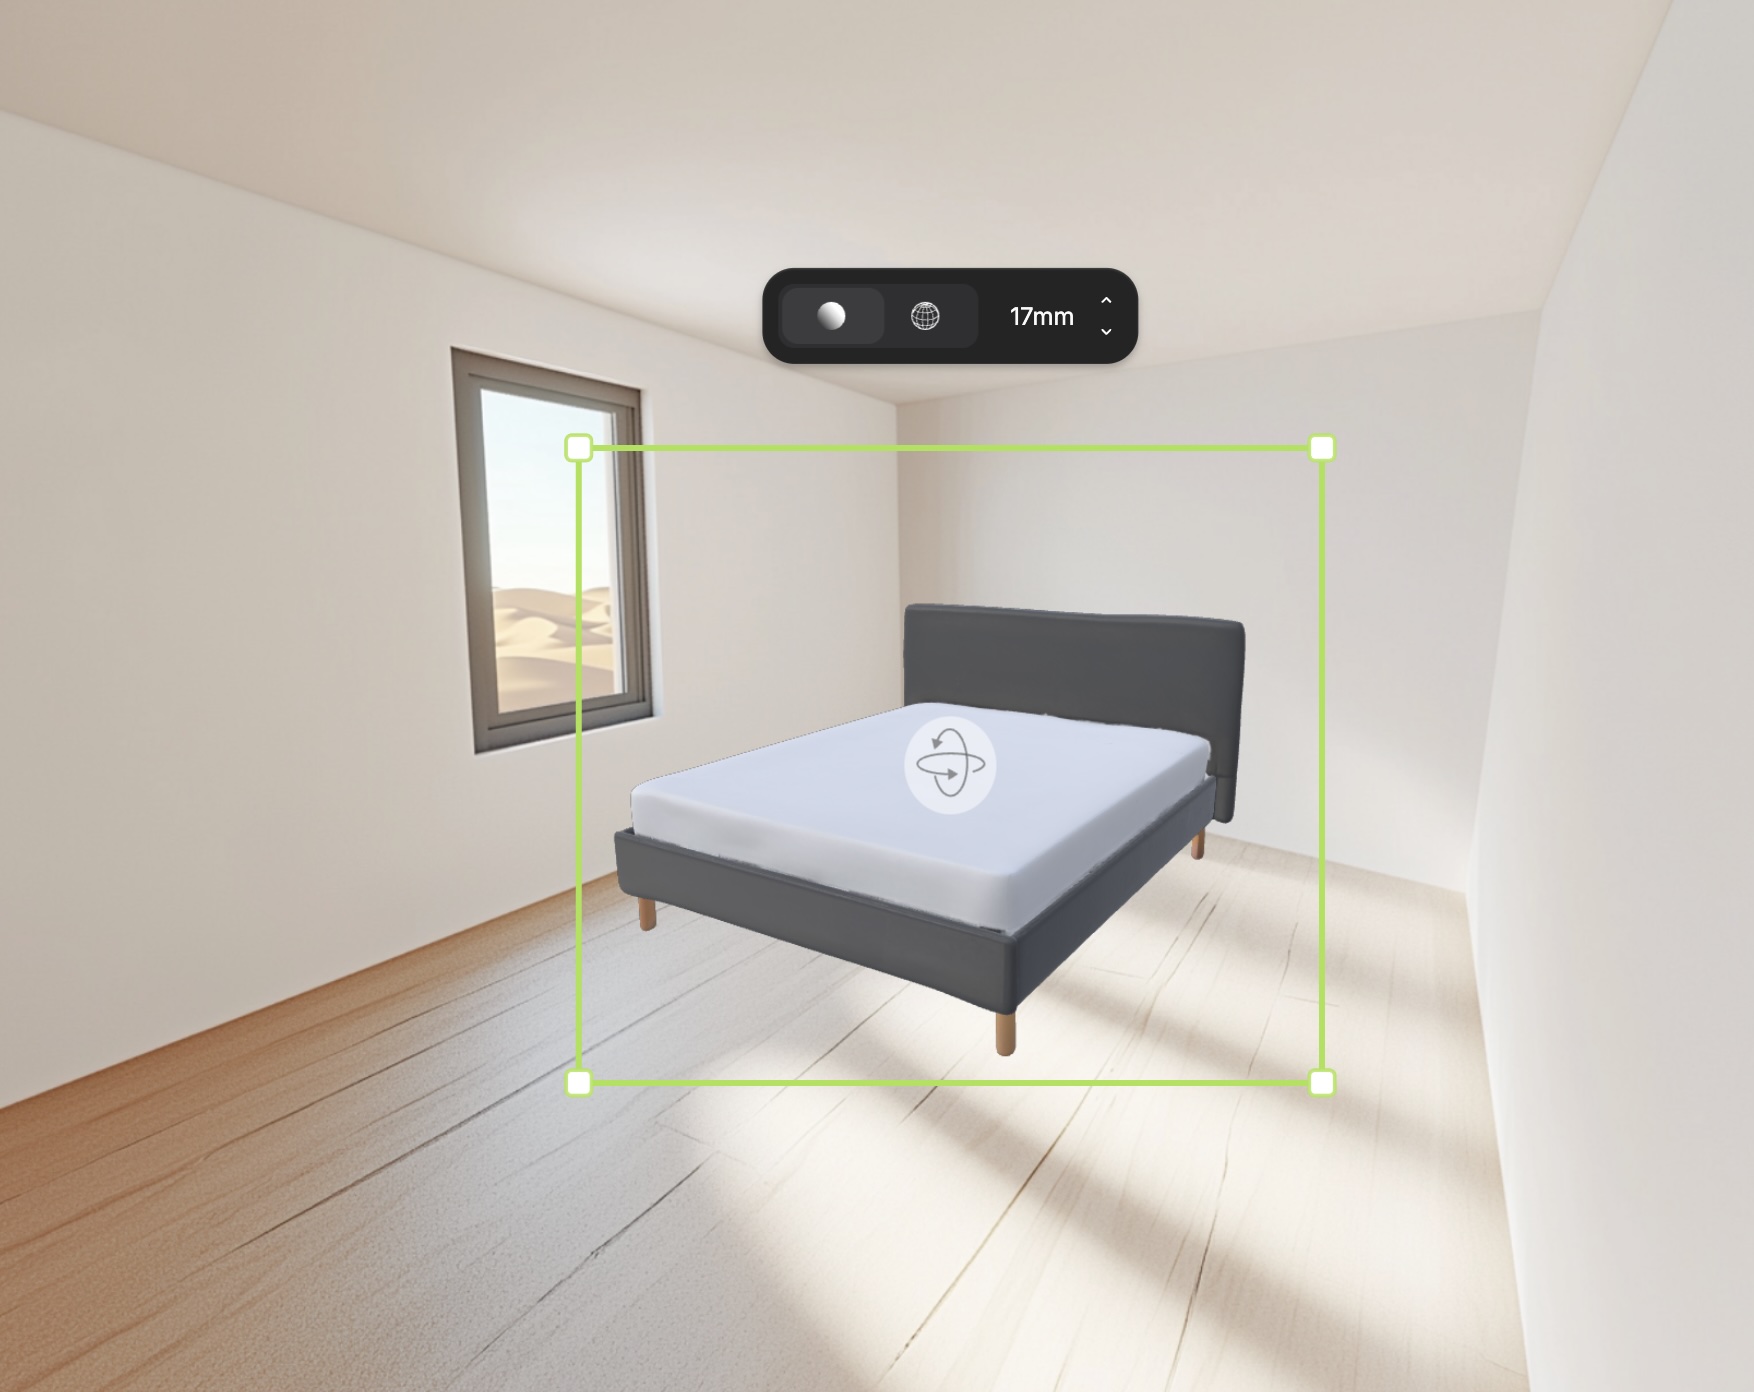
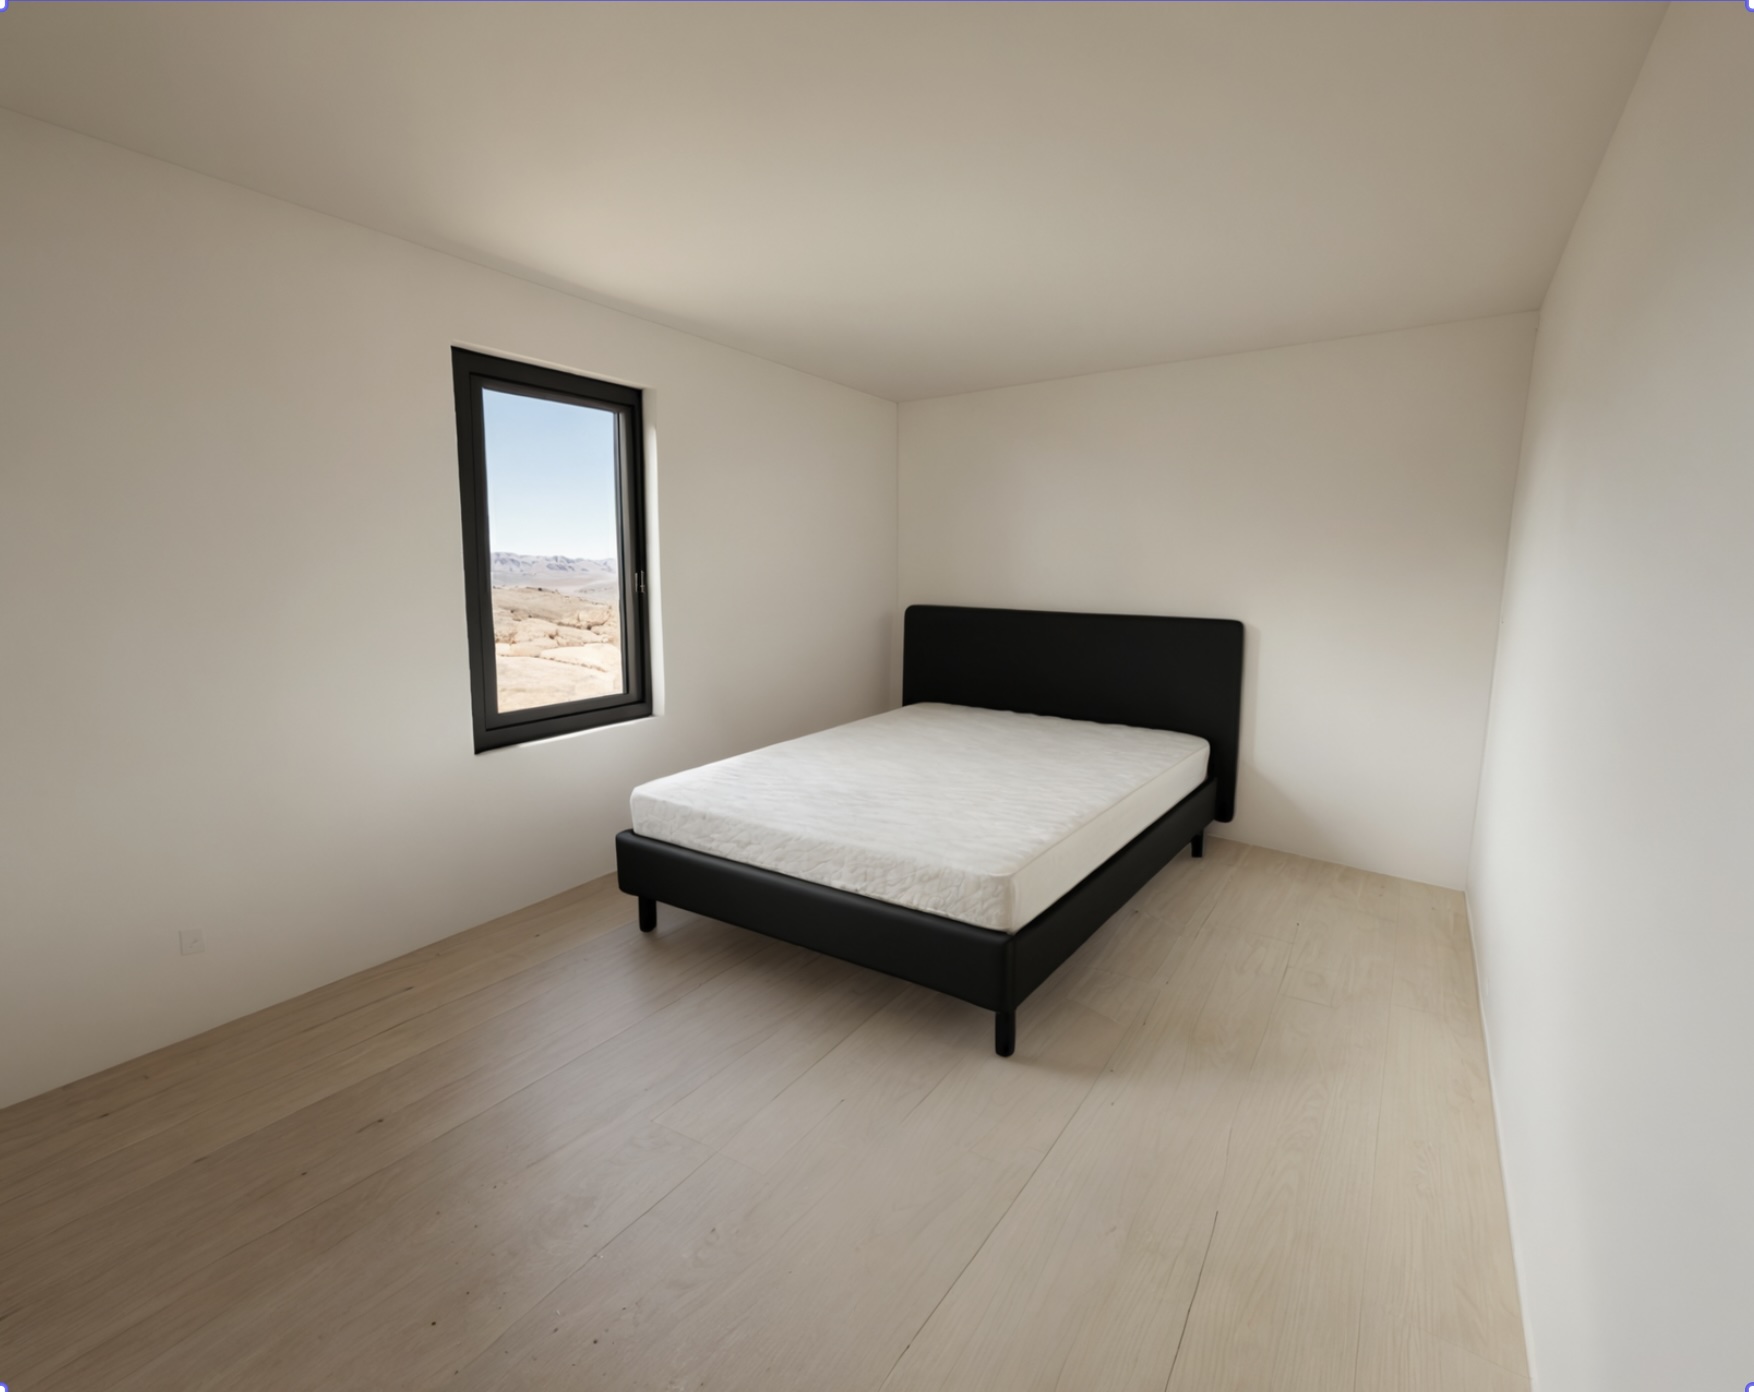
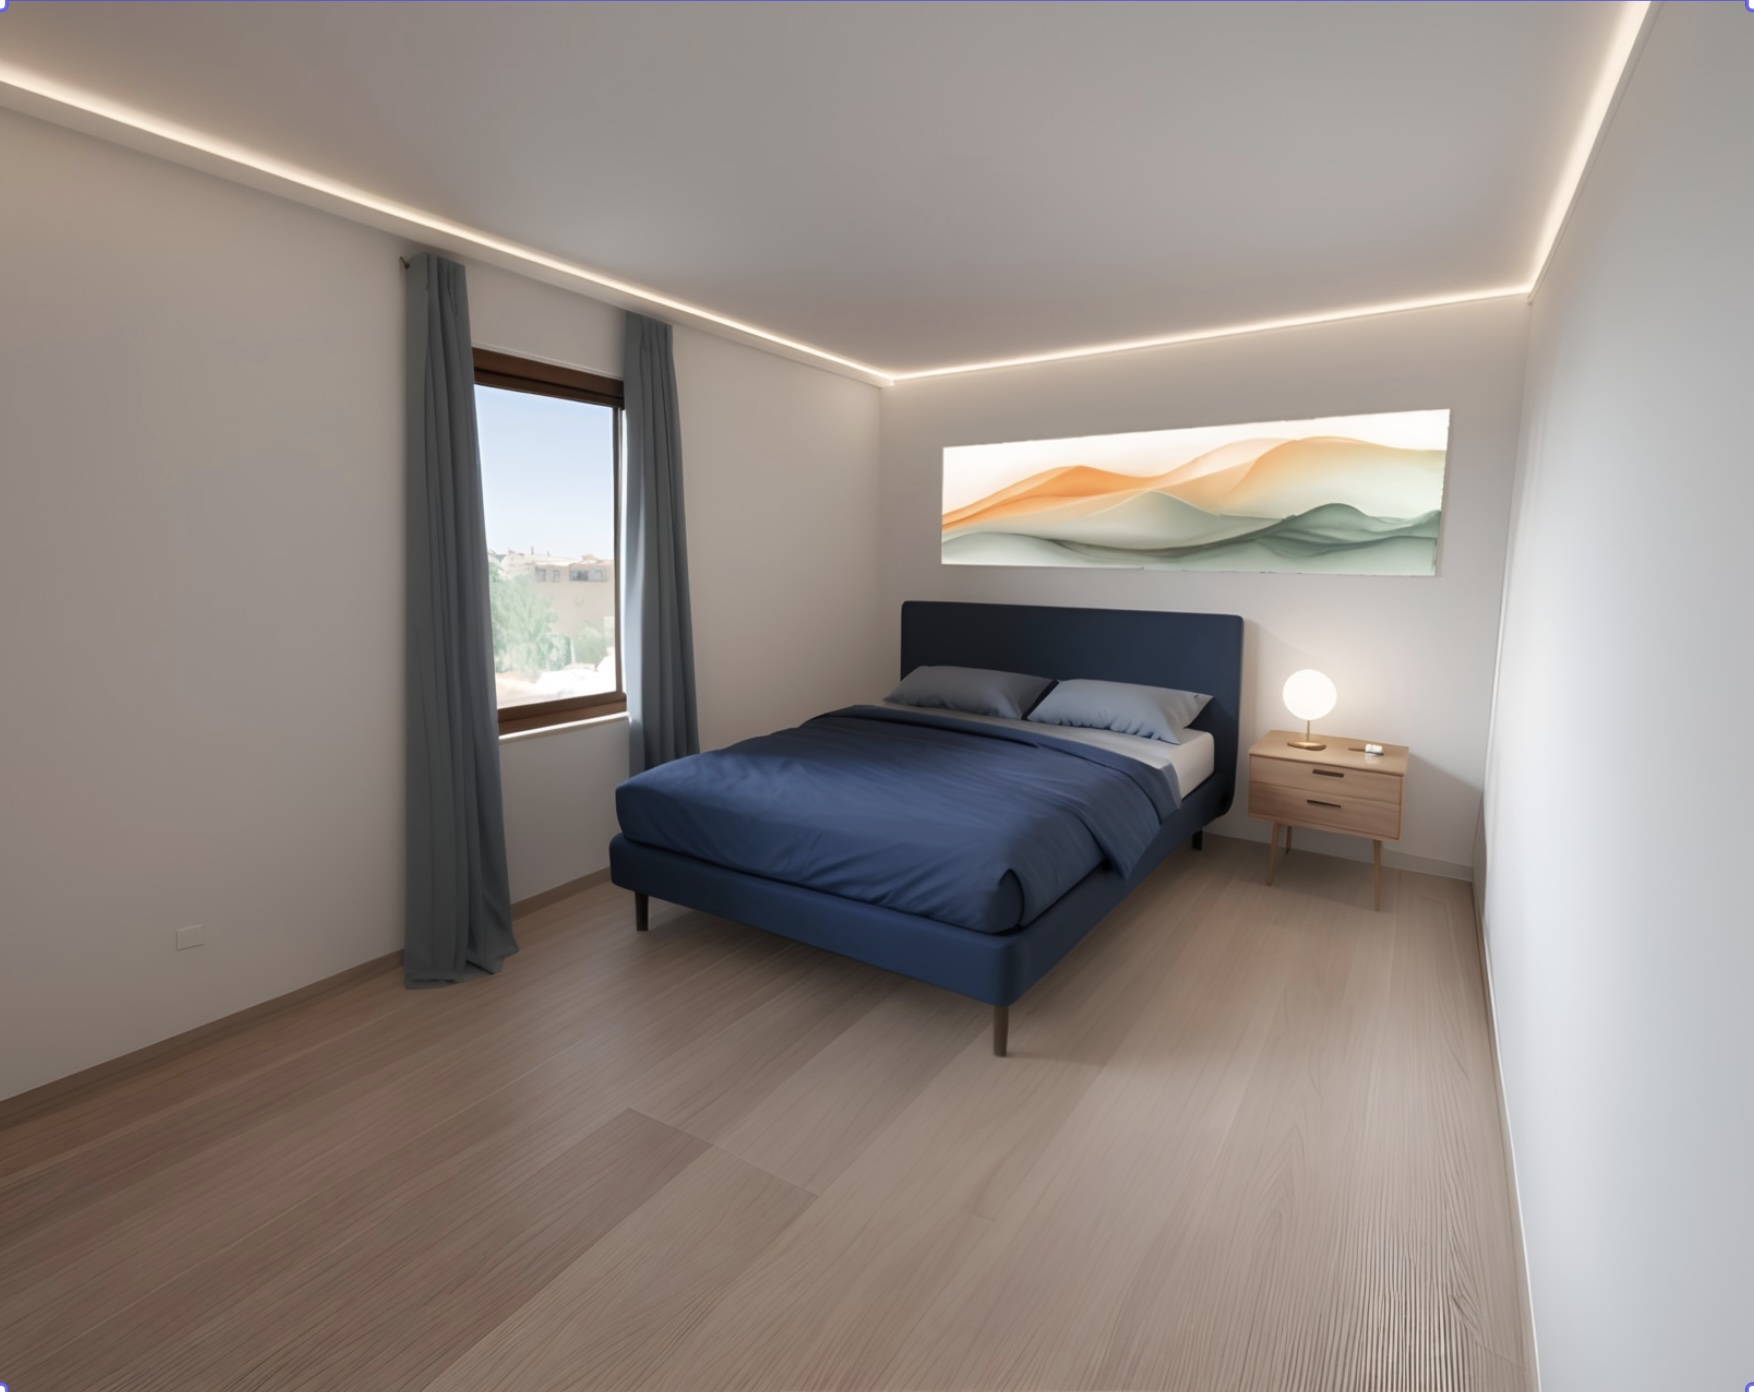
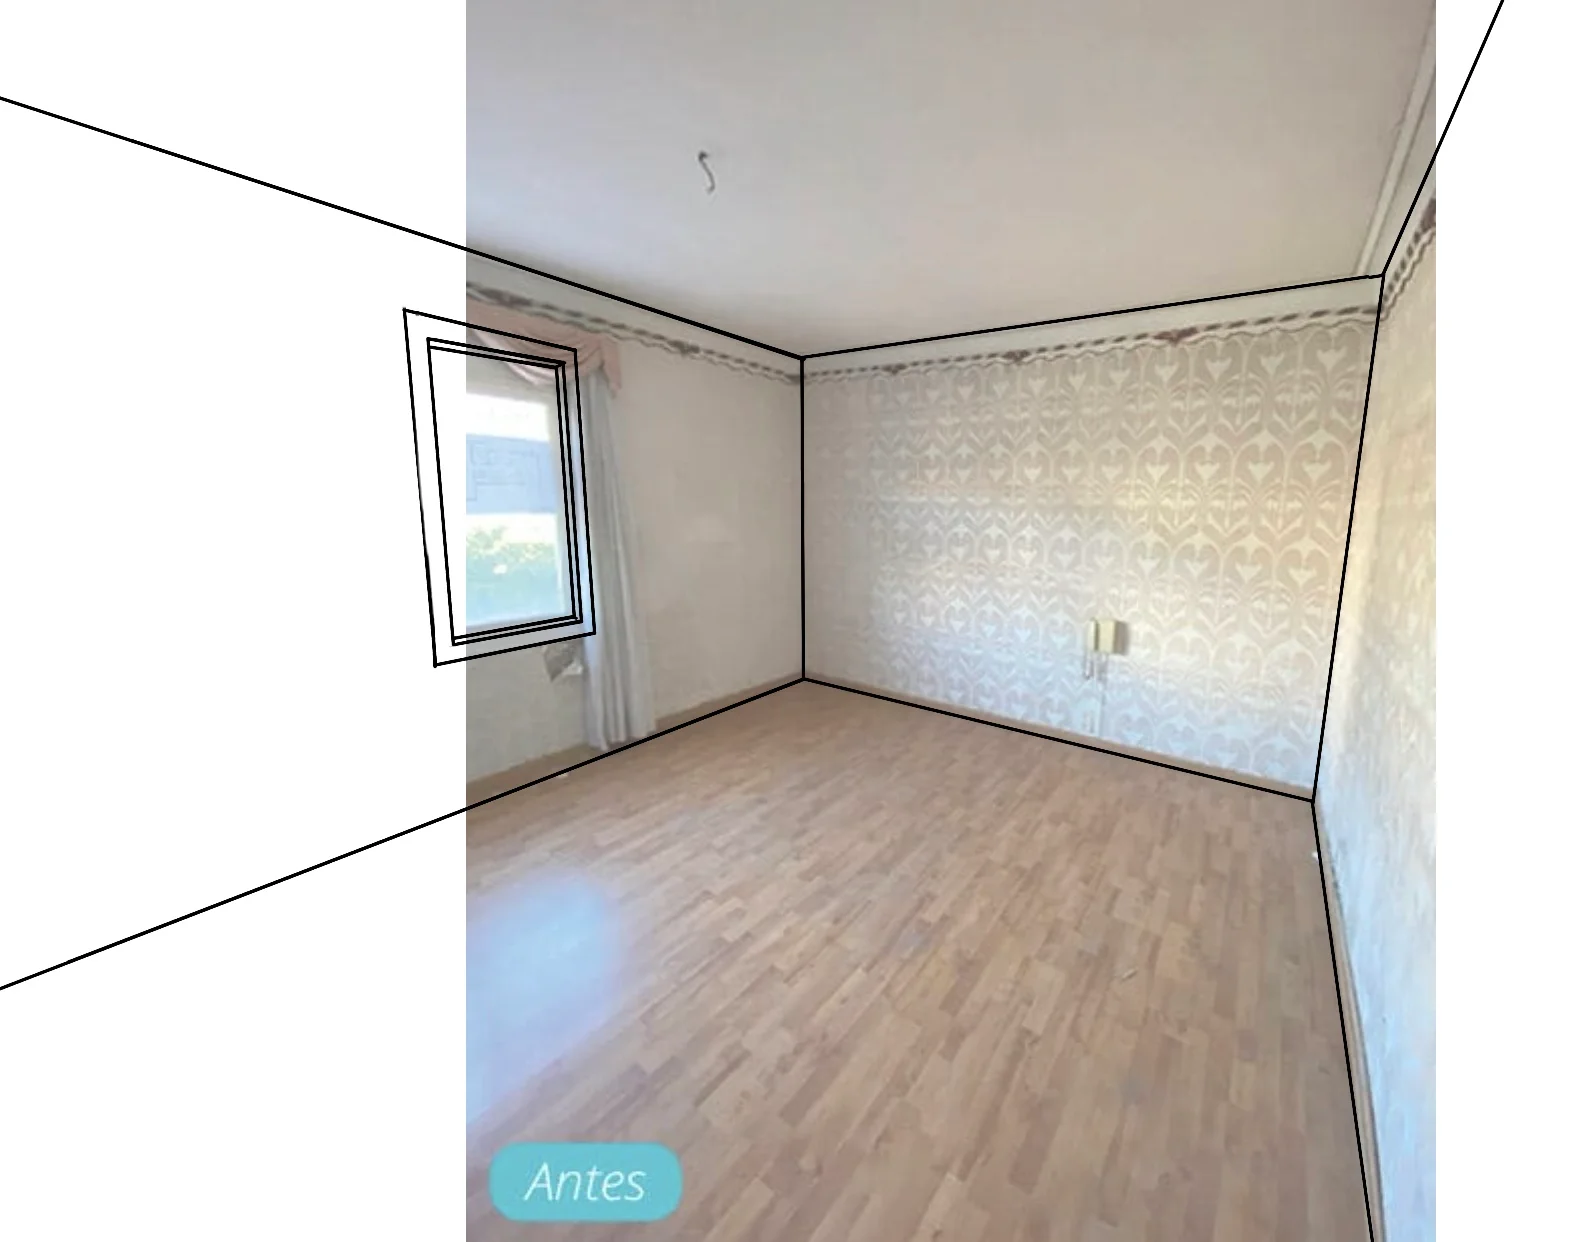
Lo que sí resulta cada vez más evidente es que el 3D tiene un papel muy valioso en la recreación de espacios vacíos, especialmente cuando se convierte en la base sobre la que aplicar técnicas más avanzadas que veremos más adelante.
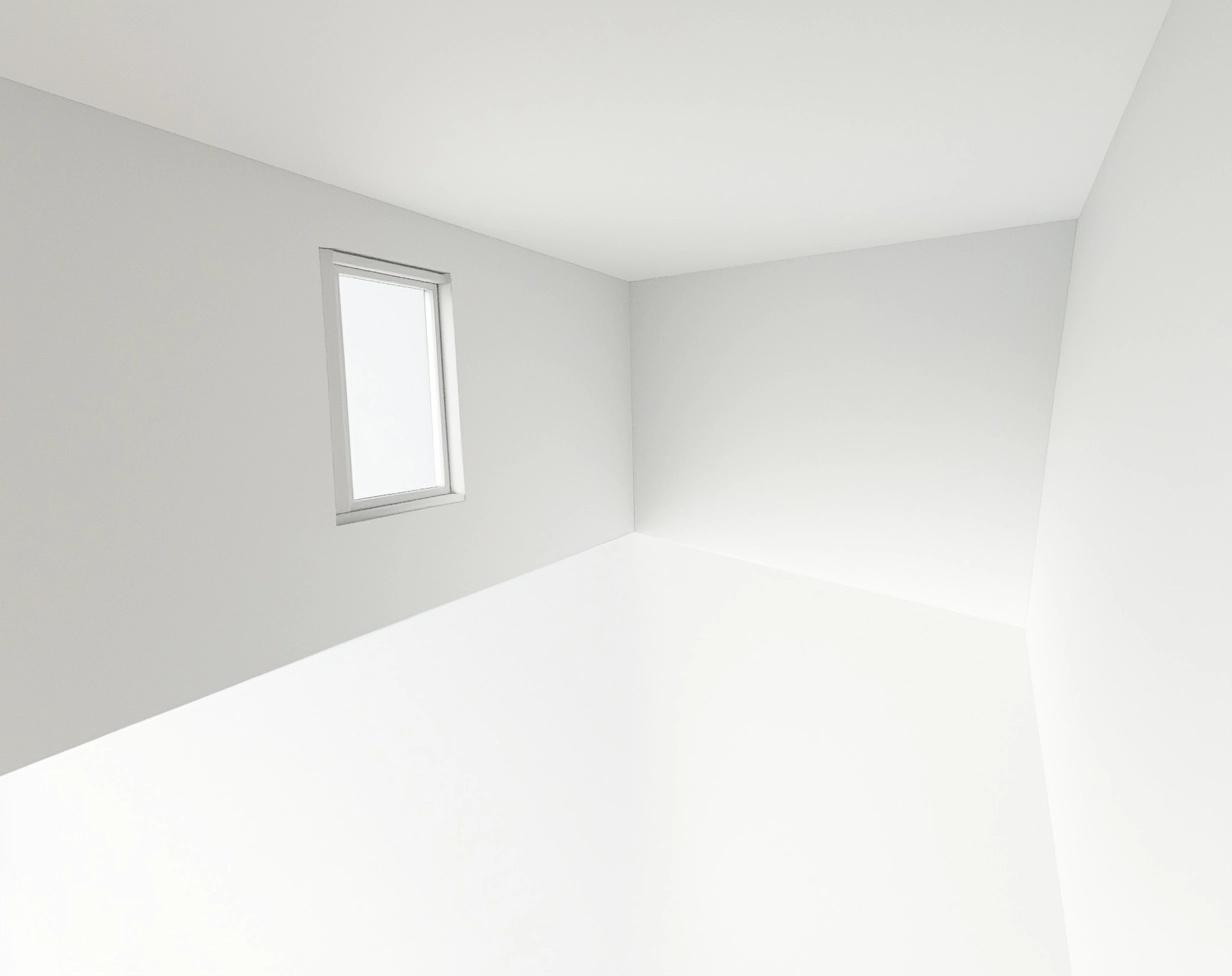
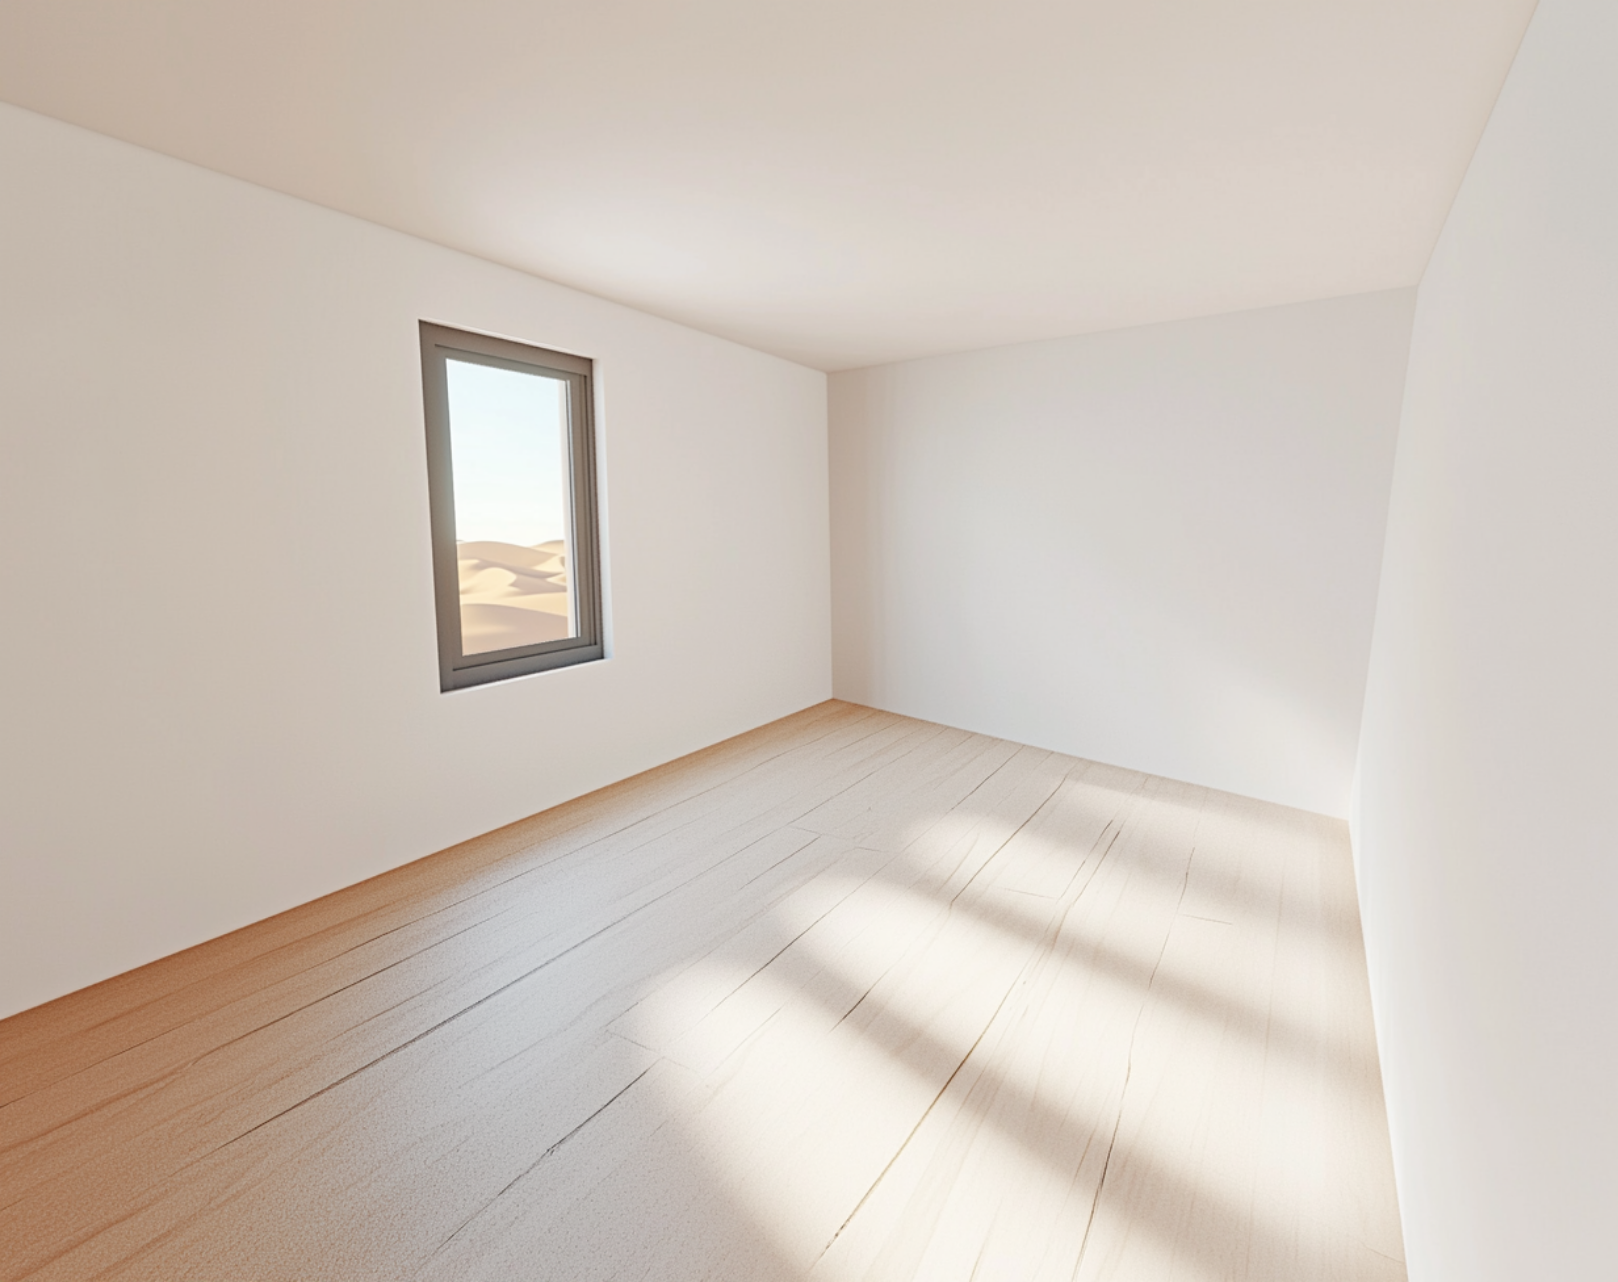
En el contexto de un proyecto de interiorismo, por ejemplo, una propuesta rápida podría partir de un modelo 3D del espacio real. A partir de ahí, generar una estancia vacía desde la que obtener distintas vistas puede ser una excelente estrategia para construir nuestras composiciones visuales.
Este enfoque abre un flujo de trabajo ágil, flexible y con gran potencial, especialmente cuando se apoya en tecnologías como el escaneo LIDAR o el Gaussian Splatting, que permiten capturar el entorno con una precisión sorprendente en cuestión de minutos.

Cabe destacar, además, que el campo del 3D generativo está en pleno auge. Las investigaciones y desarrollos en curso anticipan avances extraordinarios que ampliarán radicalmente las posibilidades creativas y técnicas en este ámbito.

LiDAR

La tecnología LiDAR (Light Detection and Ranging) permite escanear espacios físicos con una precisión milimétrica utilizando pulsos de luz láser. Gracias a esta técnica, es posible acudir a un local, vivienda u oficina y, en cuestión de minutos, capturar con altísima fidelidad la geometría del entorno. El archivo resultante genera una representación tridimensional del espacio real, que puede utilizarse como base para crear vistas interiores realistas y trabajar sobre ellas con herramientas de IA generativa aplicada al interiorismo. Esta integración entre escaneado y creatividad abre una vía espectacular para decorar y transformar espacios de forma rápida, precisa y visualmente impactante.

Esta tecnología ya está disponible en muchos teléfonos y tablets de gama Pro de Apple, lo que permite escanear espacios con gran precisión sin necesidad de equipos especializados.

Gaussian Splatting

El Gaussian Splatting es otra de esas tecnologías increíbles que ya tenemos al alcance de la mano gracias a aplicaciones móviles capaces de capturar espacios en cuestión de minutos. A partir de un simple recorrido con la cámara, el sistema genera una nube de puntos enriquecida con color y volumen, ofreciendo una representación sorprendentemente realista del entorno. Su base está en la fotogrametría, pero va un paso más allá, permitiendo resultados mucho más rápidos y livianos.

Este tipo de captura nos permite «revisitar» digitalmente el espacio y hacer capturas desde cualquier ángulo, lo que resulta ideal para generar renders interiores o escenas mediante IA generativa. Si en lugar de un espacio escaneamos un mueble, objeto decorativo u obra artística, podremos integrarlo directamente en programas de edición o composición visual. El Gaussian Splatting se perfila como una de las tecnologías más prometedoras del momento por su ligereza, inmediatez y capacidad de integración con nuevos flujos creativos.

Sistemas híbridos 2D/3D

Feather 3d

(iPad)

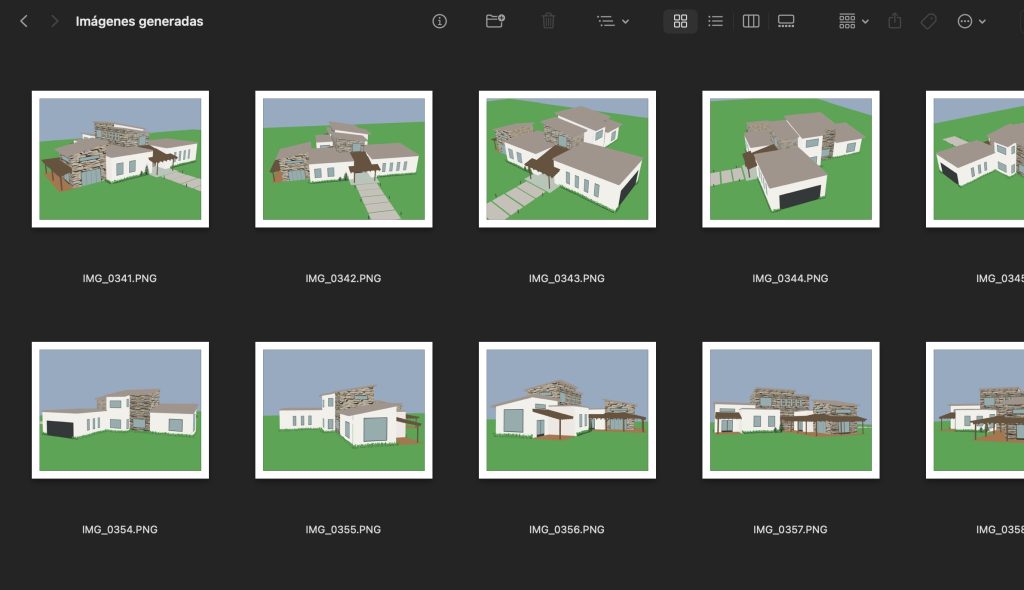
Feather 3D es una aplicación para iPad que permite dibujar en 2D dentro de un entorno tridimensional, combinando la inmediatez del trazo manual con la profundidad espacial del 3D. A partir de formas planas, podemos construir composiciones que se perciben con volumen y perspectiva, lo que abre la puerta a nuevas formas de representar espacios sin necesidad de dominar complejos programas de modelado.

Desarrollé un flujo de trabajo propio que aprovecha esta herramienta para generar imágenes ricas en contenido espacial, listas para ser interpretadas por inteligencia artificial. Sin pasar por softwares tradicionales de 3D, es posible producir bocetos funcionales, atractivos y cargados de información visual que pueden servir como punto de partida para presentaciones, exploraciones estéticas o pruebas rápidas de estilo.

A continuación podéis ver un ejemplo generado a partir de este sistema. El resultado es sorprendente teniendo en cuenta la simplicidad del punto de partida y la rapidez del proceso.

Resultado del proceso

Este flujo de trabajo partía de un proyecto con planta y alzados bien definidos, lo que me permitió establecer una base precisa desde el primer momento. A partir de esos planos, generé una serie de texturas bidimensionales que coloqué estratégicamente dentro de Feather 3D. Gracias a la capacidad de la aplicación para situar elementos 2D en un espacio tridimensional, pude construir un modelo híbrido 2D/3D, lo suficientemente estructurado como para trabajar cómodamente con él.

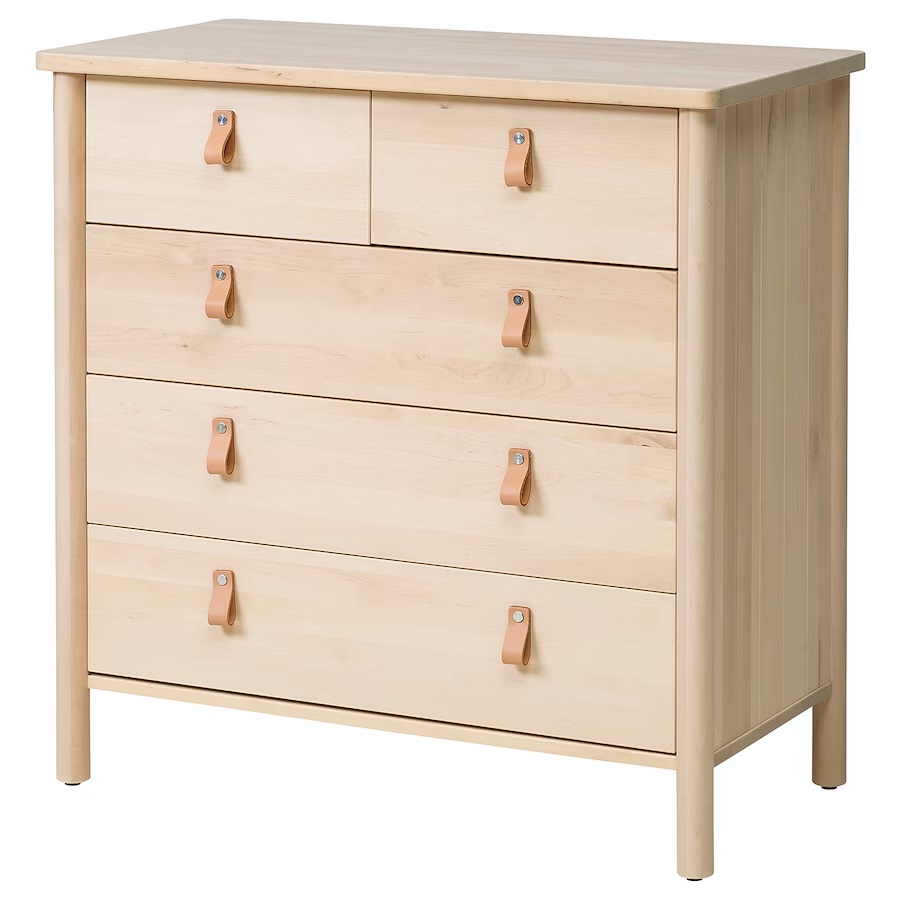
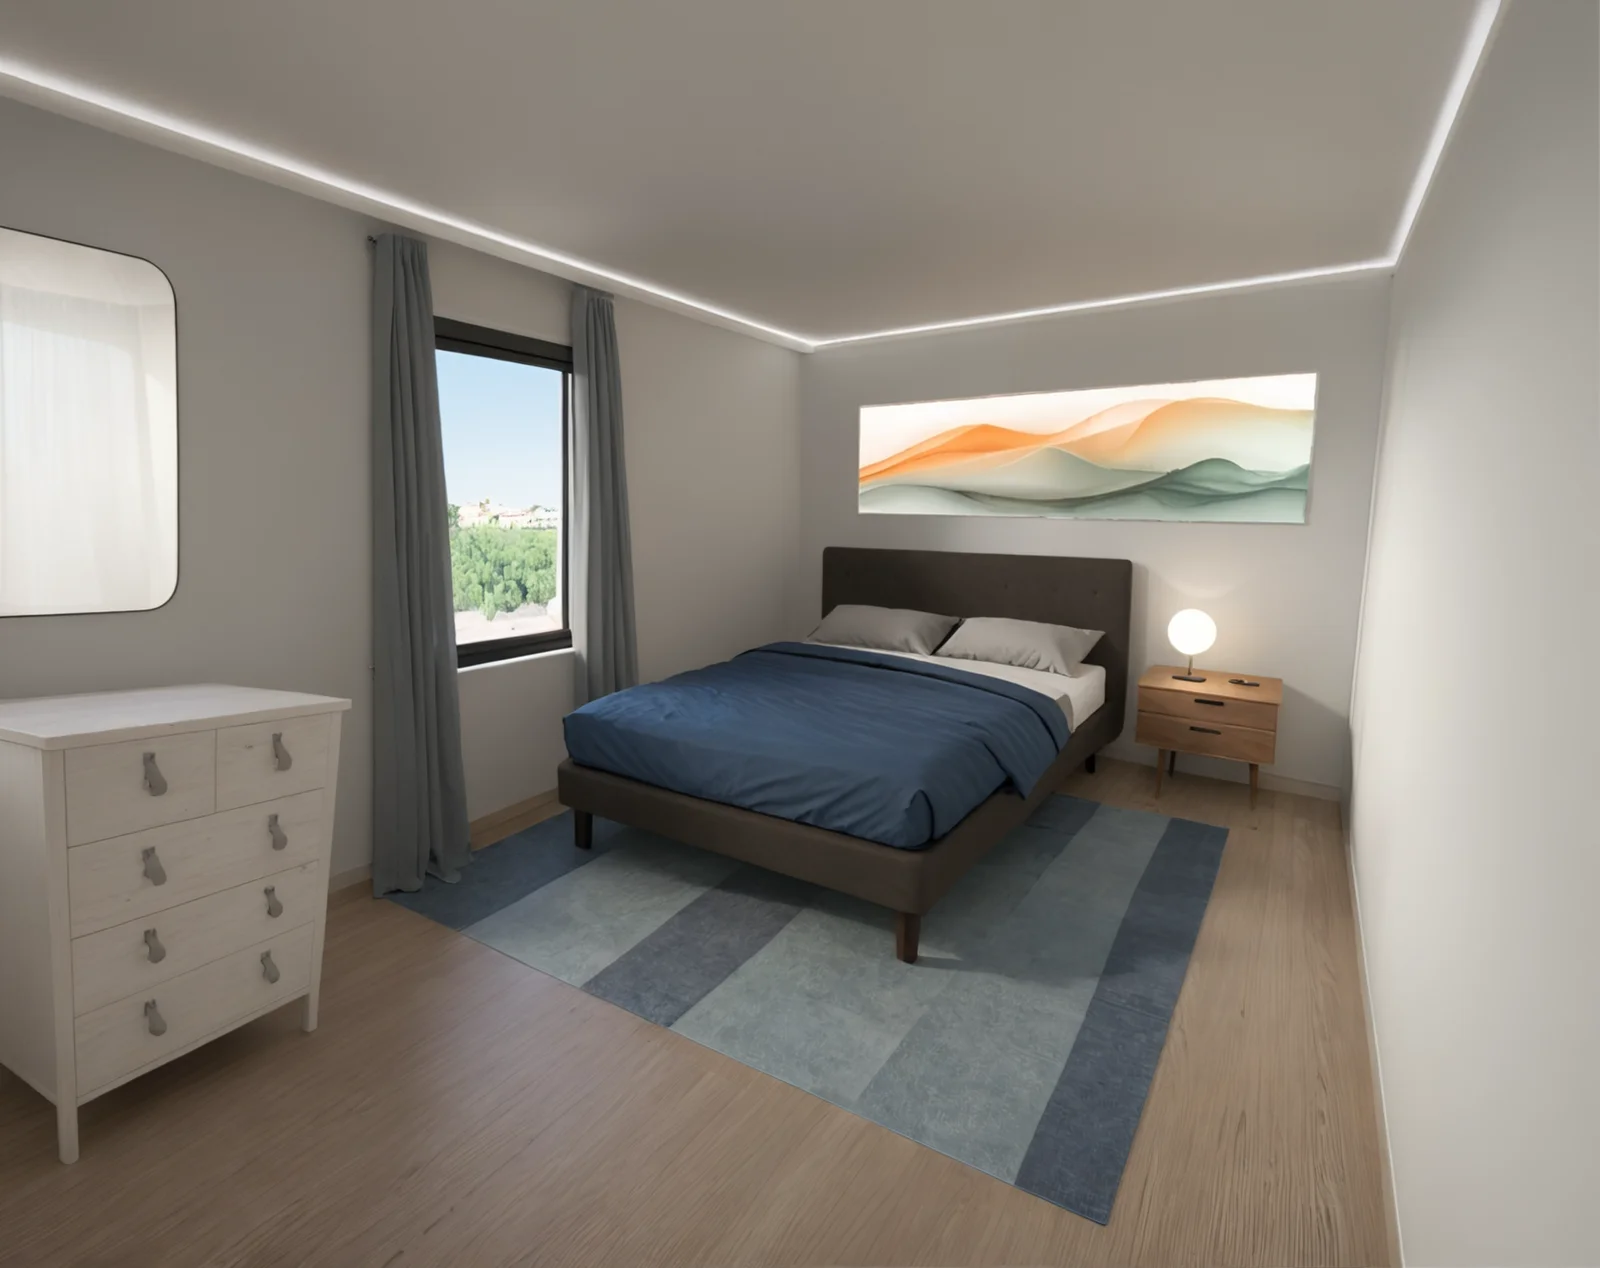
Una vez creado este modelo base, fue posible generar múltiples vistas del espacio, eligiendo los encuadres más interesantes según el objetivo del proyecto. El paso final consistió en procesar esas vistas con IA generativa, obteniendo imágenes renderizadas con gran nivel de detalle, listas para presentar o para utilizarlas en fases posteriores del desarrollo visual. El resultado es una combinación sorprendente de agilidad, control y expresividad, sin necesidad de recurrir a programas de modelado 3D tradicionales.

Y llegamos a la

EDICIÓN

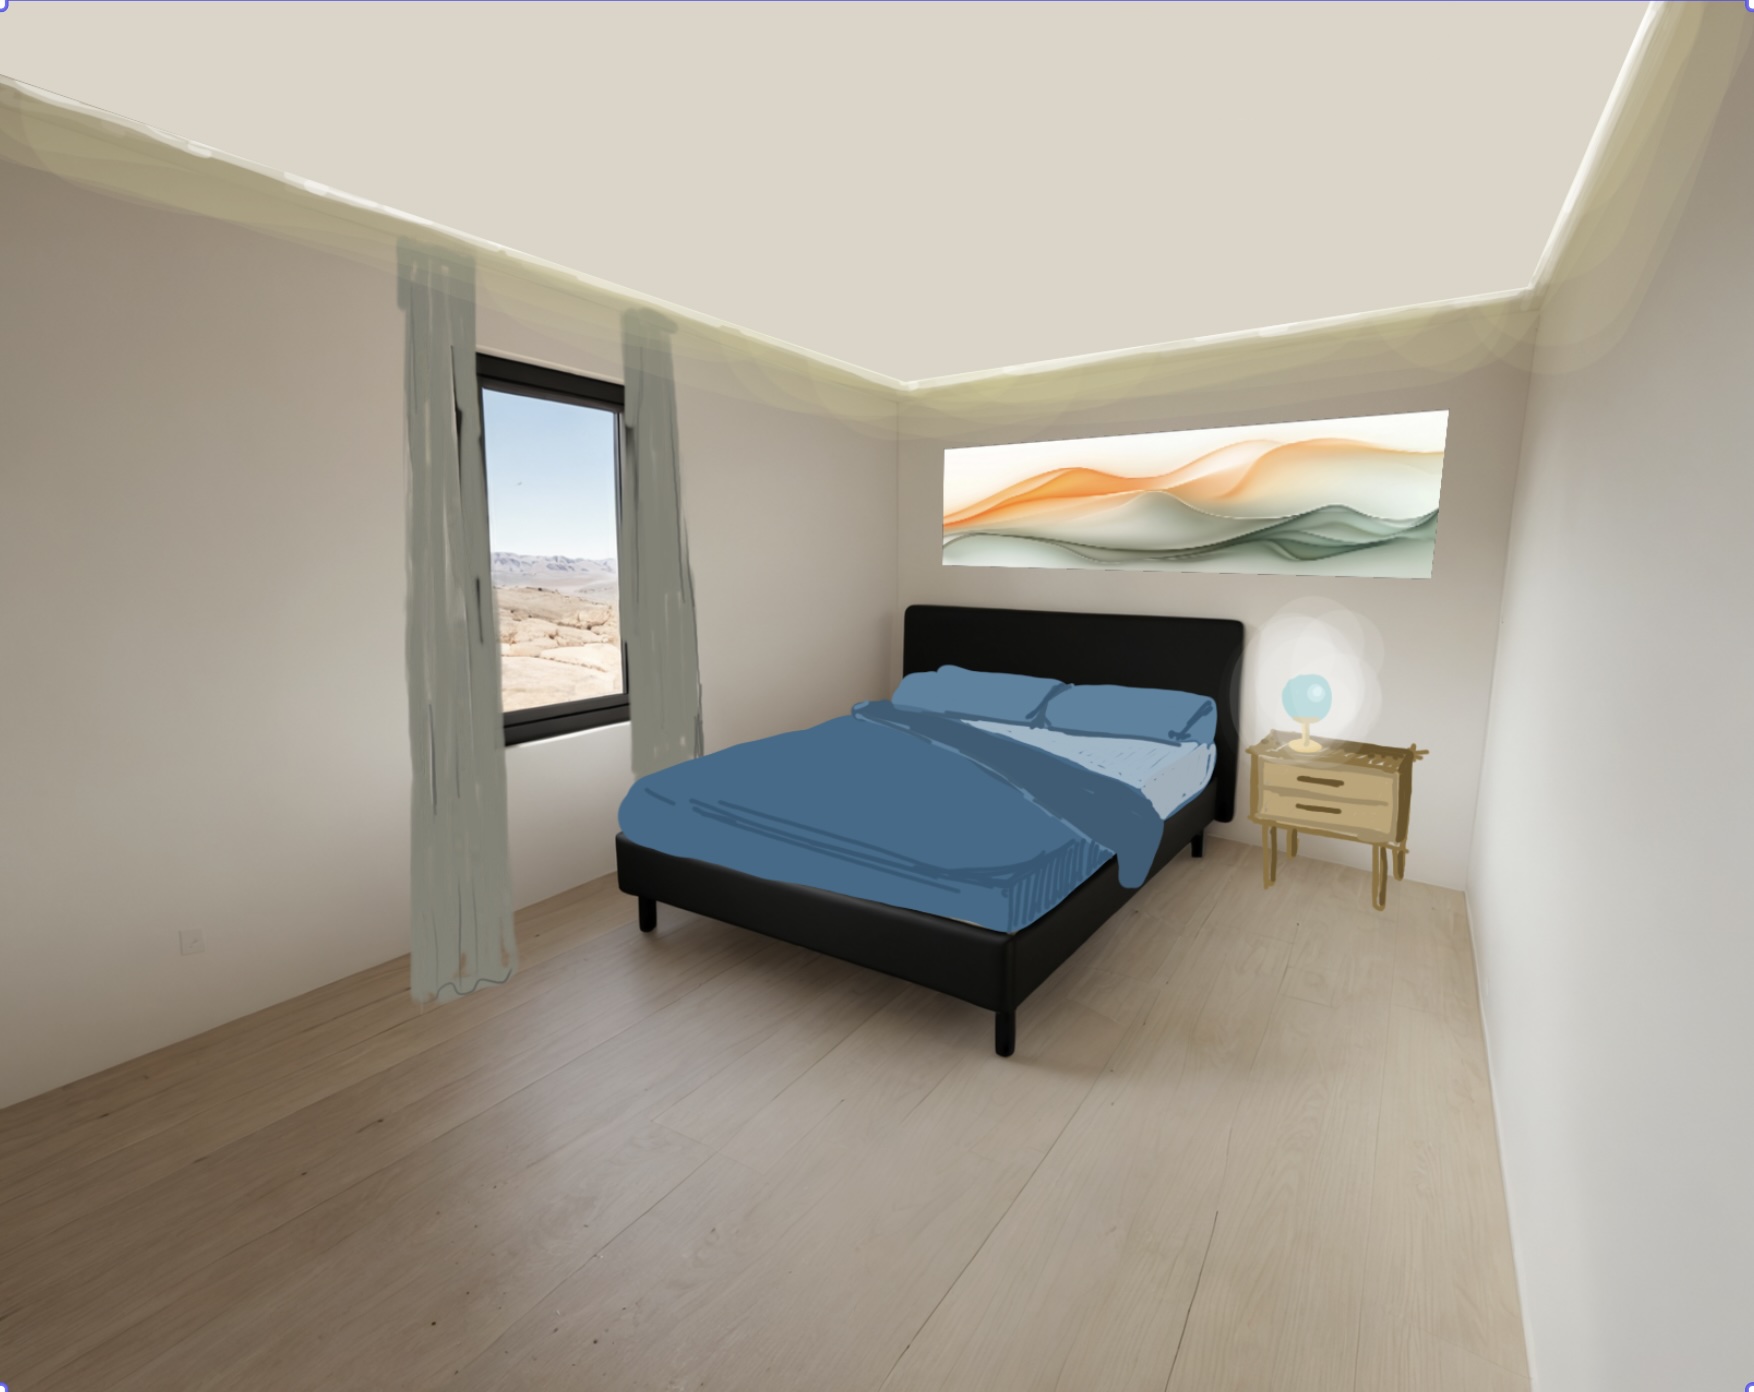
La edición mediante lenguaje natural lo ha cambiado todo. Hasta hace poco, las aplicaciones de generación de imágenes no disponían de herramientas de edición verdaderamente potentes. Hoy, pedirle a la IA un cambio concreto sobre tu propia imagen y verlo aplicado es precisamente el terreno donde compiten los modelos más avanzados: seleccionar, retocar, sustituir elementos o cambiar un acabado se hace conversando. Lo que hace apenas un par de años parecía impensable es ya la forma habitual de trabajar.

En este escenario de evolución constante, he probado decenas de herramientas con distintos enfoques y grados de desarrollo. Solo puedo recomendar con verdadera convicción el uso combinado de Vizcom y Midjourney, una dupla que permite generar resultados de altísima calidad y además intervenir sobre ellos con una libertad sorprendente. Vizcom, en particular, marca la diferencia cuando se trata de ajustar, reinterpretar o transformar imágenes de manera precisa y visualmente coherente, gracias a su sistema de control por máscaras, referencias de estilo y capacidad de mantener la esencia del diseño original.

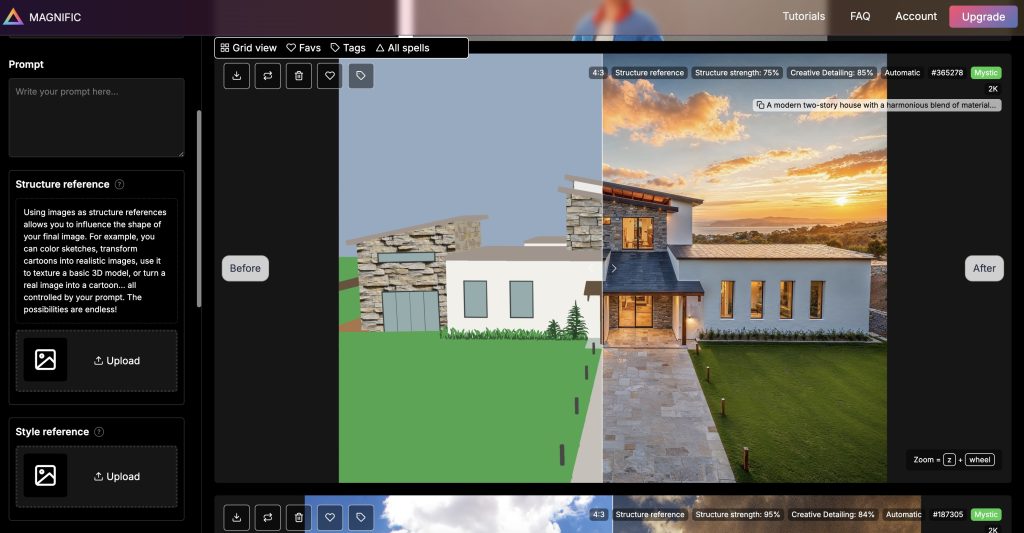
Es cierto que plataformas como Magnific.ai, Krea.ai u otras pueden resultar útiles en momentos puntuales, sobre todo para tareas muy específicas o efectos rápidos. Sin embargo, ninguna alcanza el nivel de control y finura en la edición que ofrece Vizcom cuando se parte de un boceto. Para quienes buscamos algo más que una imagen impactante y queremos construir un discurso visual sólido, la diferencia es evidente. Eso sí, conviene tener el ojo abierto: han aparecido alternativas centradas específicamente en arquitectura e interiorismo, que entienden mejor la escala y la iluminación de un espacio.

Herramientas de edición

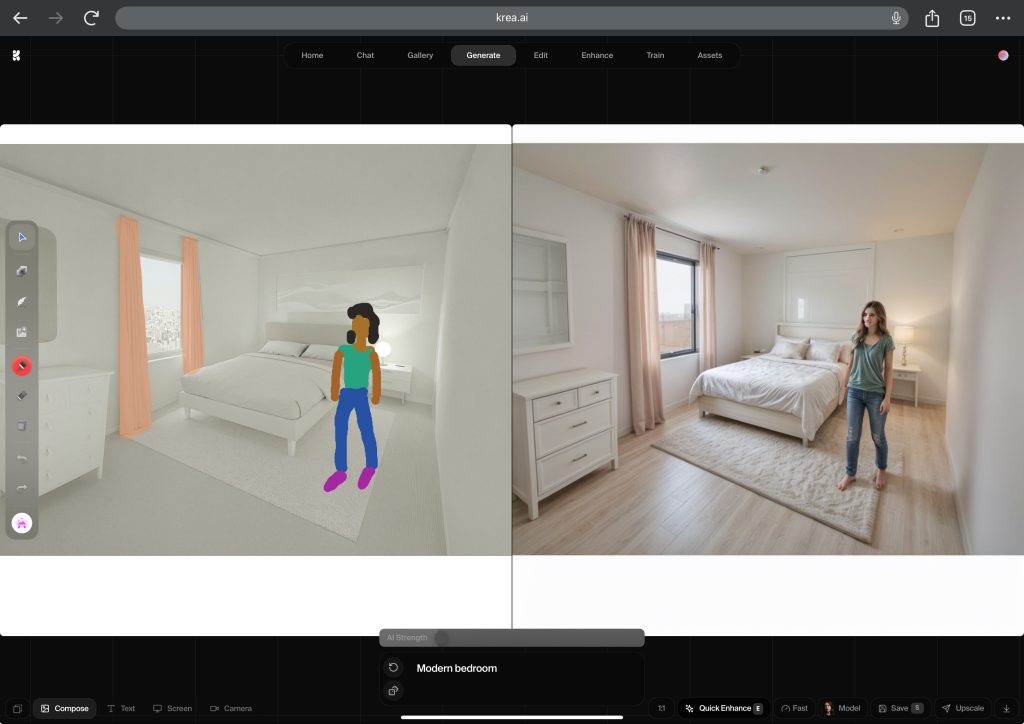
Herramientas como las de Midjourney (derecha) o el panel de dibujo en tiempo real de Krea.ai (izquierda), ofrecen opciones para realizar ediciones básicas directamente sobre ciertas áreas de la ilustración. Aunque sus funciones aún son limitadas en comparación con programas de edición tradicionales, permiten introducir cambios rápidos de forma visual e intuitiva.

En particular, el sistema de dibujo en tiempo real de Krea.ai merece una mención especial, ya que se ha convertido en una de las herramientas más potentes y versátiles dentro del panorama creativo actual. Su capacidad para combinar trazos manuales con generación asistida por IA abre nuevas posibilidades expresivas que van mucho más allá del simple retoque.

Herramientas de mejora (enhanced)

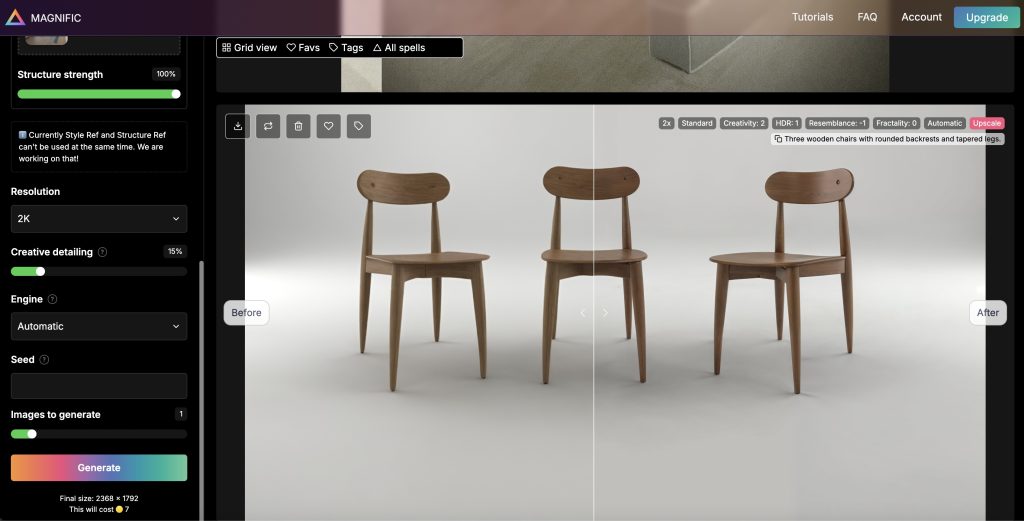
Muchas de las soluciones actuales incorporan herramientas de mejora y escalado generativo, pero si hay una empresa que ha destacado a nivel internacional, esa es Magnific.ai. Desde su sede en Murcia, han desarrollado una de las tecnologías de escalado generativo más avanzadas del mercado, ofreciendo resultados que marcan la diferencia en términos de nitidez, detalle y coherencia visual. Su trayectoria ha sido tan notable que acabaron siendo adquiridos por Freepik, la reconocida plataforma con sede en Málaga.

Conviene subrayar que el escalado generativo va mucho más allá de la simple interpolación de píxeles que realizan los softwares tradicionales. Este tipo de tecnología es capaz de reinterpretar y reconstruir la imagen original, añadiendo nuevos niveles de detalle según los parámetros que definamos. El resultado son imágenes de altísima resolución y calidad, perfectas para aplicaciones exigentes como la impresión en gran formato o la producción editorial de alto nivel.

Vizcom

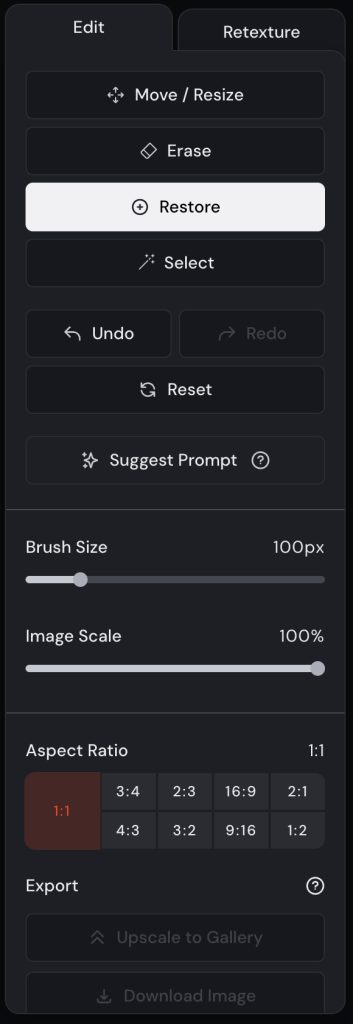
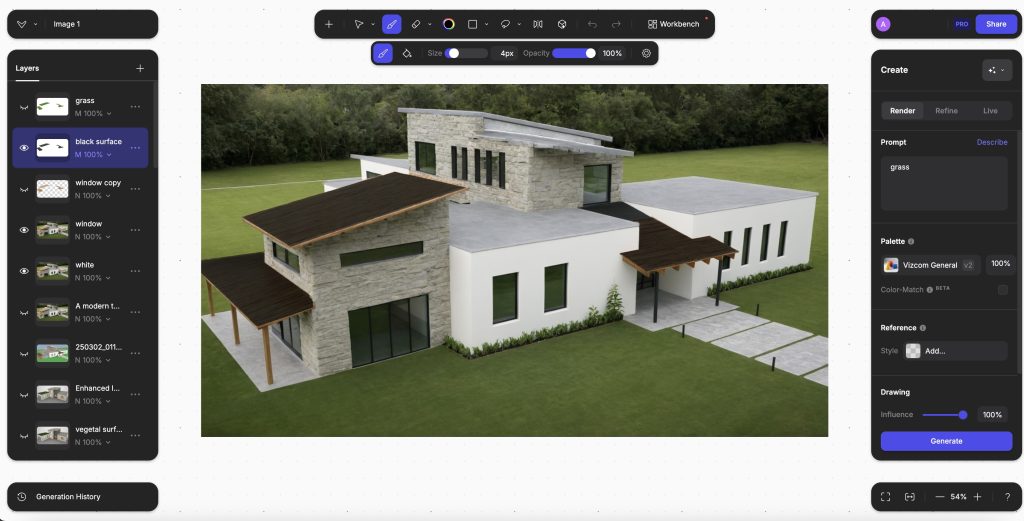
Entre las distintas herramientas de edición mediante IA generativa, Vizcom destaca como una de las más completas y versátiles. No se limita a generar imágenes desde un prompt, sino que permite al usuario intervenir activamente en el proceso, aportando control y precisión en cada paso.

La plataforma ofrece un abanico de funciones que la sitúan por encima de muchas alternativas: trabajo por capas, inclusión de imágenes de referencia, integración y generación de modelos 3D, dibujo en tiempo real, entrenamiento de LoRAs y un canvas organizado para proyectos más complejos. Todo esto la convierte en una herramienta especialmente útil para quienes necesitan algo más que un resultado aleatorio.

No es una aplicación económica, pero dispone de una versión gratuita que, pese a ciertas limitaciones, permite trabajar con fluidez y explorar buena parte de su potencial. Ideal para quienes buscan un entorno más controlado y profesional dentro del universo de la IA generativa.

Interface de Vizcom

Proceso de diseño

Comparativa

Variaciones en Midjourney

3D generativo

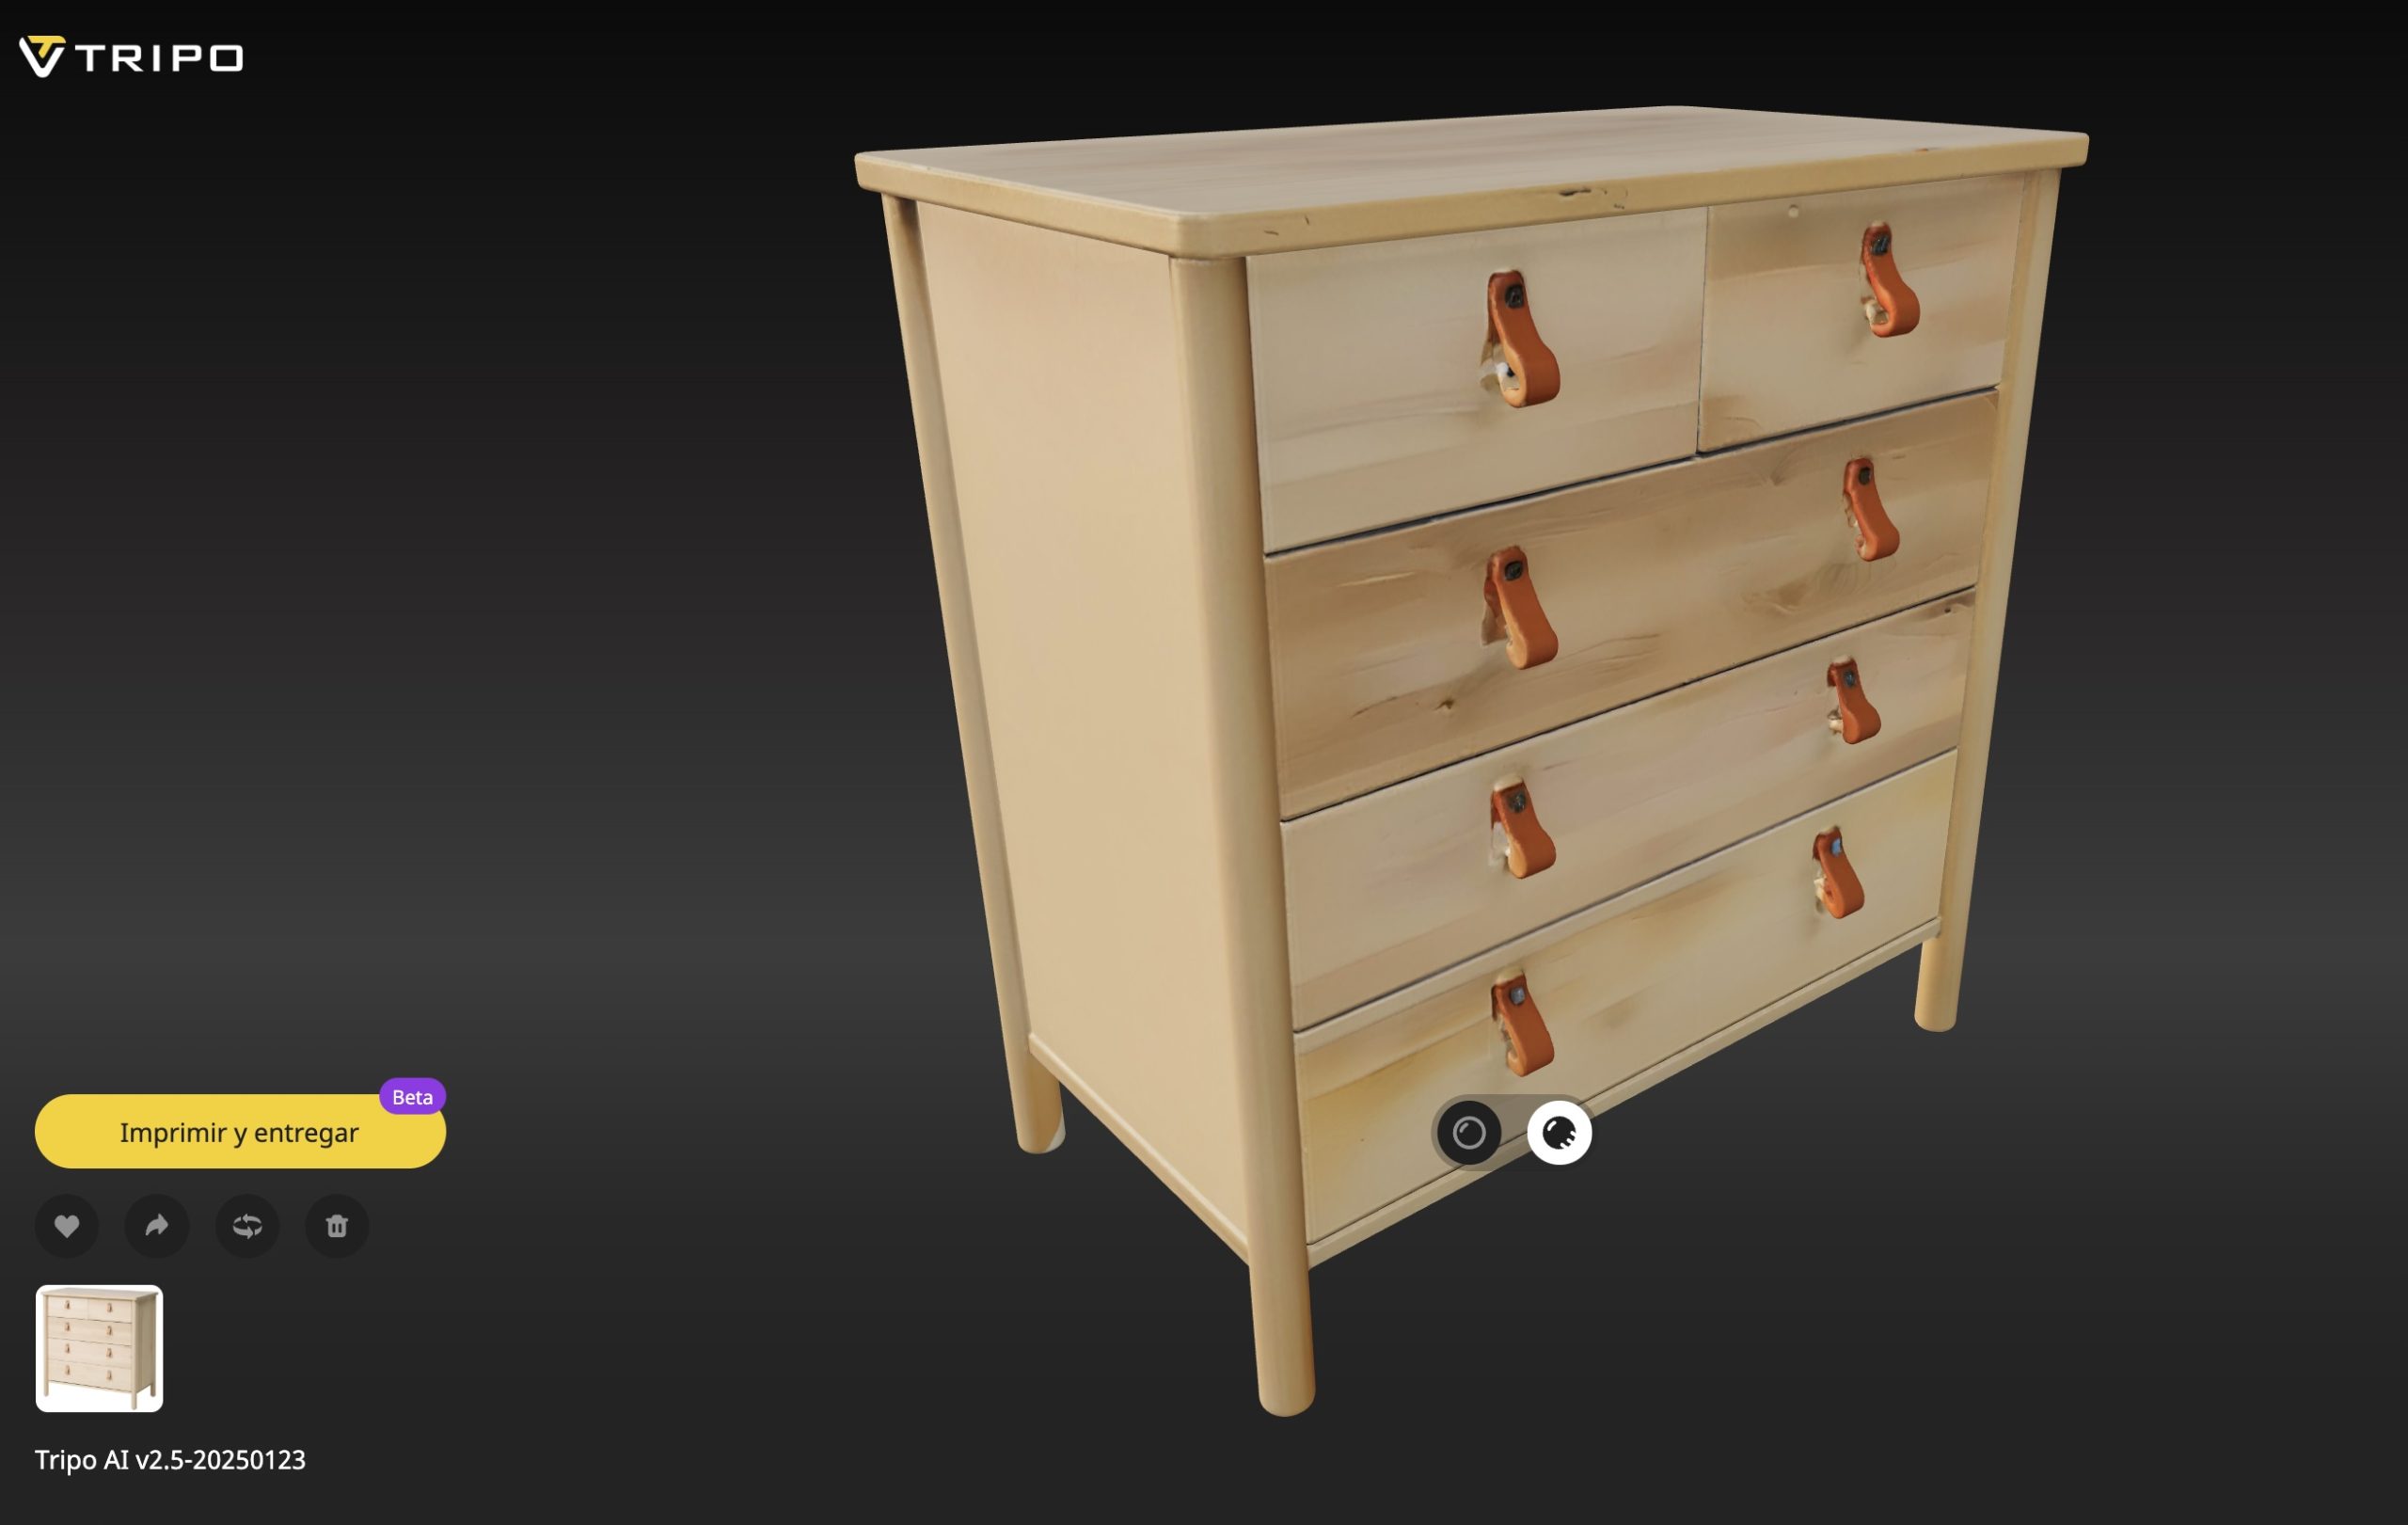
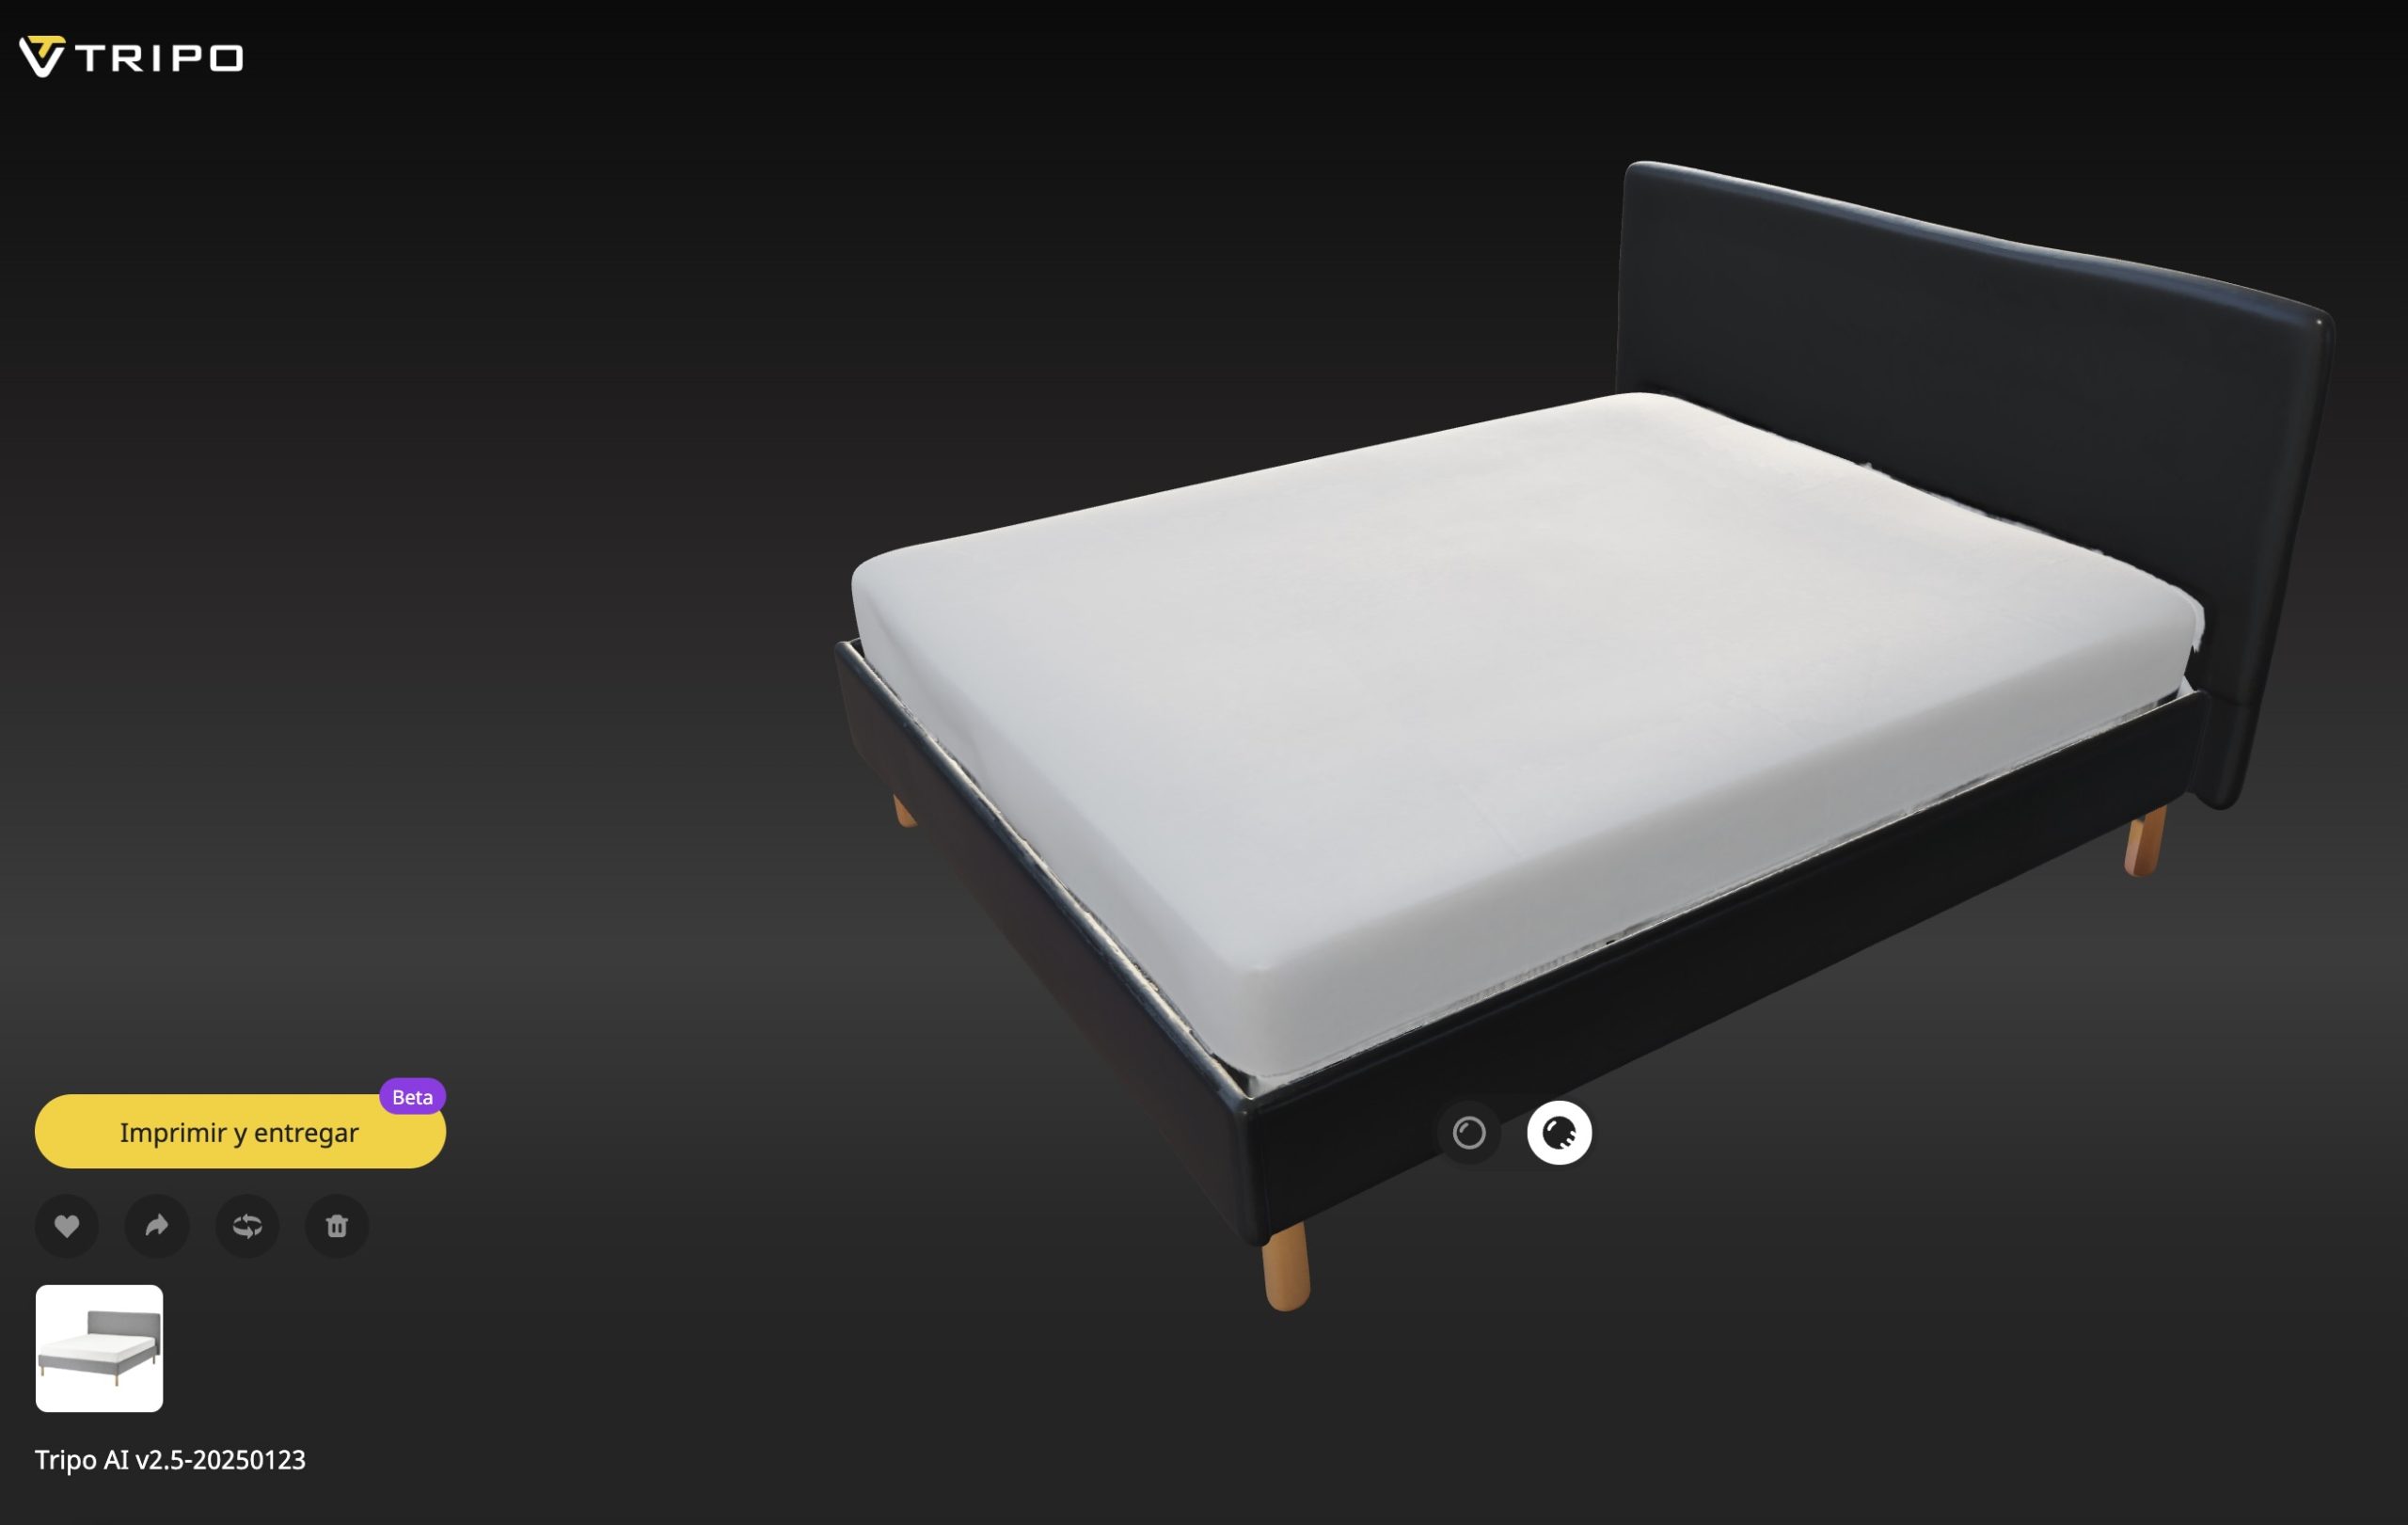
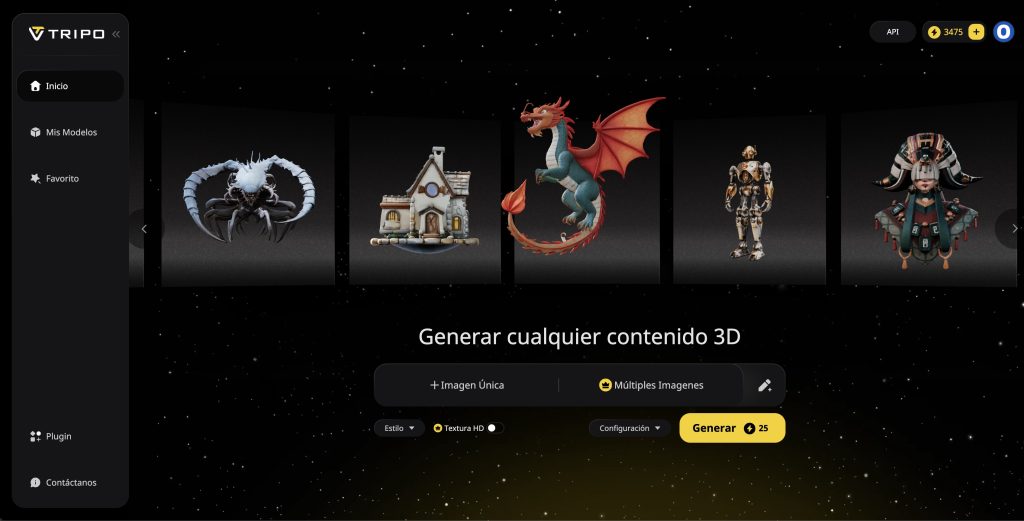
Hasta ahora hemos visto herramientas que permiten capturar espacios en 3D, pero el 3D generativo representa una de las disciplinas más prometedoras dentro de la inteligencia artificial. A diferencia de las técnicas de escaneo, el 3D generativo parte de la idea de crear geometría (o estructuras como el Gaussian Splatting) a partir de diferentes tipos de entrada: desde un simple prompt, una única imagen (reconstruyendo incluso las partes no visibles) o un conjunto de vistas que permiten definir con mayor precisión el modelo.

Estas piezas generadas pueden integrarse fácilmente en programas de modelado 3D convencionales o, en nuestro caso, servir como base de trabajo directamente en plataformas como Vizcom, abriendo nuevas posibilidades creativas sin necesidad de partir desde cero.

Panel de entrada de Tripo, uno de los mejores generadores de 3D